【重磅发布】CosyVoice 3.0 技术指南:下一代零样本语音生成模型实战
FunAudioLLM 团队于 2025-12-15 正式发布 CosyVoice 3.0:支持 9 种语言与 18+ 方言、发音修补、更强的指令控制。本文提供首发技术解读与本地部署全流程。
本文发布于 277 天前,内容可能已过时,请注意甄别。
1. 🚀 重磅发布:CosyVoice 3.0 来了
2025年12月15日,FunAudioLLM 团队正式开源发布了 CosyVoice 3.0。作为 CosyVoice 系列的最新迭代,3.0 版本在“野外场景(in-the-wild)”的语音生成能力上再次实现了质的飞跃。
相比于 2.0 版本,3.0 版本的核心突破在于:
- 更强的模型底座:官方强烈推荐使用
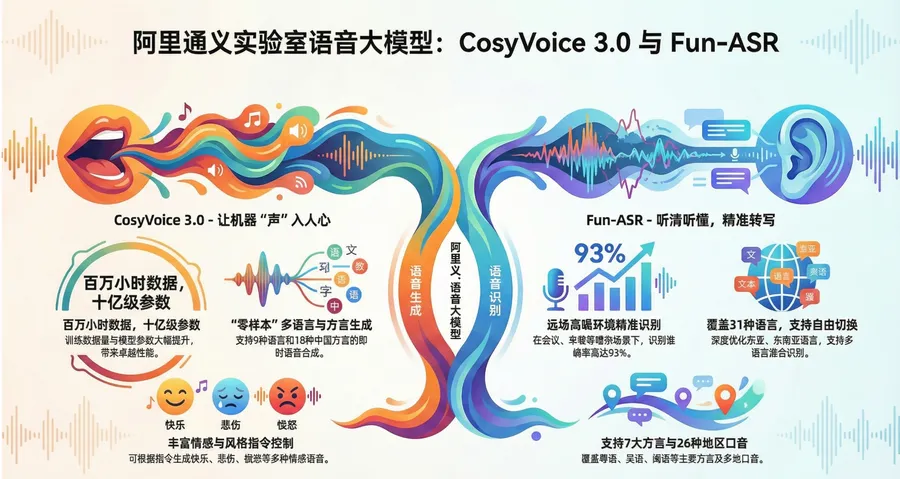
Fun-CosyVoice3-0.5B,在保持轻量级(0.5B)的同时,效果全面超越前代。 - 全能语言覆盖:原生支持 9 种主流语言(中、英、日、韩、德、西、法、意、俄)以及 18+ 种中文方言(粤语、闽南语、四川话、东北话、上海话等)。
- 极致的可控性:新增 Pronunciation Inpainting(发音修补)功能,支持拼音/音素级的精细调节。
- 指令驱动:支持通过 Instruct 指令控制语速、情感(Emotion)、音量等,让语音生成更具表现力。
官方资源直达:
- 📦 代码仓库:GitHub - FunAudioLLM/CosyVoice
- 🎮 在线体验:ModelScope 创空间
2. 环境准备与安装
作为首发技术指南,我们第一时间梳理了本地部署流程。建议使用 Linux 或 Windows (WSL2) 环境,并配备 NVIDIA 显卡。
2.1 克隆仓库与环境配置
       # 1. 克隆代码(注意 --recursive,包含子模块)
git clone --recursive https://github.com/FunAudioLLM/CosyVoice.git
cd CosyVoice
# 如果子模块拉取失败,可单独执行:
# git submodule update --init --recursive

# 2. 创建 Conda 环境(官方推荐 Python 3.10)
conda create -n cosyvoice -y python=3.10
conda activate cosyvoice

# 3. 安装依赖(使用阿里云镜像加速)
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com

# 4. (可选) 系统级依赖(解决 sox 兼容性问题)
# Ubuntu: sudo apt-get install sox libsox-dev
# CentOS: sudo yum install sox sox-devel
3. 模型下载(最新 3.0 版本)
官方目前提供了多个版本的模型,生产环境与体验强烈建议优先下载 Fun-CosyVoice3-0.5B-2512。
       from modelscope import snapshot_download
import os

# 创建模型存放目录
os.makedirs('pretrained_models', exist_ok=True)

# 下载 CosyVoice 3.0 核心模型 (推荐)
snapshot_download('FunAudioLLM/Fun-CosyVoice3-0.5B-2512', local_dir='pretrained_models/Fun-CosyVoice3-0.5B')

# (可选) 下载 CosyVoice 2.0 及其他旧版本
# snapshot_download('iic/CosyVoice2-0.5B', local_dir='pretrained_models/CosyVoice2-0.5B')

# (可选) 下载 TTS 前端处理增强包 (推荐下载,提升文本归一化效果)
snapshot_download('iic/CosyVoice-ttsfrd', local_dir='pretrained_models/CosyVoice-ttsfrd')
4. 实战推理:从 0 到 1
4.1 基础推理
仓库根目录下的 example.py 是最快的上手入口。它展示了如何加载模型并进行简单的语音合成。
python example.py4.2 WebUI 交互式体验
CosyVoice 3.0 提供了功能完善的 WebUI,适合探索不同 Prompt 和指令对声音的影响。
       # 启动 WebUI,指定模型路径为刚下载的 3.0 版本
python3 webui.py --port 50000 --model_dir pretrained_models/Fun-CosyVoice3-0.5B
启动后,浏览器访问 http://localhost:50000,你可以在界面上尝试:
- 零样本克隆:上传一段 3-10 秒的参考音频,输入文本,即可生成同音色语音。
- 跨语种克隆:用中文参考音频合成英文语音(3.0 版本对此做了极大优化)。
- 指令控制:在高级选项中调整语速、情感。
4.3 高级特性:Pronunciation Inpainting
3.0 版本引入的“发音修补”功能非常实用。当你发现模型对某些多音字或生僻词读音不准时,可以直接通过拼音/音素进行干预,无需重新训练模型。这对于垂直领域(医疗、法律等)的应用至关重要。
5. 部署建议
对于希望将 CosyVoice 3.0 集成到业务系统的开发者,官方提供了标准的容器化方案。
Docker 部署 (gRPC / FastAPI)
       cd runtime/python
docker build -t cosyvoice:v1.0 .

# 启动 gRPC 服务
docker run -d --runtime=nvidia -p 50000:50000 cosyvoice:v1.0 /bin/bash -c "cd /opt/CosyVoice/CosyVoice/runtime/python/grpc && python3 server.py --port 50000 --max_conc 4 --model_dir iic/CosyVoice-300M && sleep infinity"

# 启动 FastAPI 服务
docker run -d --runtime=nvidia -p 50000:50000 cosyvoice:v1.0 /bin/bash -c "cd /opt/CosyVoice/CosyVoice/runtime/python/fastapi && python3 server.py --port 50000 --model_dir iic/CosyVoice-300M && sleep infinity"
注意:部署时请将 model_dir 替换为 Fun-CosyVoice3-0.5B 的实际路径。
6. 常见问题 (FAQ)
Q: CosyVoice 3.0 和 2.0 的主要区别是什么? A: 3.0 在多语种支持(特别是方言)、韵律自然度和可控性(发音修补)上更强,且模型参数保持在 0.5B,推理效率依旧很高。
Q: 为什么 git clone 速度很慢?
A: 仓库包含 submodule,建议配置 Git 代理或使用国内镜像源。
Q: Windows 下遇到 sox 报错怎么办?
A: Windows 原生不支持 sox,建议跳过系统级 sox 安装,确保 python 环境中的 torchaudio 能正常工作即可,或者使用 WSL2 获得完整的 Linux 体验。
CosyVoice 3.0 的发布标志着开源语音生成模型进入了“全能且可控”的新阶段。无论是做短视频配音、智能客服,还是个性化语音交互,它都是目前极具竞争力的选择。
更多文章