DeepSeek-V4 发布:1M 上下文标配,Agent 能力超越开源模型,优于 Claude Sonnet 4.5
DeepSeek-V4 正式发布!百万上下文标配,Agent 能力超越开源模型,推理性能比肩 GPT-4o 和 Claude Opus。Pro 版本达到顶级闭源模型水平,Flash 版本更快更经济。全新注意力机制 + DSA 稀疏注意力,计算和显存需求大幅降低
本文发布于 148 天前,内容可能已过时,请注意甄别。
2026 年 4 月 24 日,DeepSeek 正式发布全新系列模型 DeepSeek-V4 并同步开源。
核心数据:1M(百万 token)上下文标配,在 Agentic Coding 评测中达到开源模型最佳水平,数学、STEM、竞赛型代码测评超越所有已公开评测的开源模型。
在实际使用中,DeepSeek-V4-Pro 的表现优于 Claude Sonnet 4.5,交付质量接近 Claude Opus 4.6 非思考模式。目前该模型已成为 DeepSeek 公司内部员工使用的主力 Agentic Coding 工具。
从今天开始,1M 上下文成为 DeepSeek 所有官方服务的标准配置。
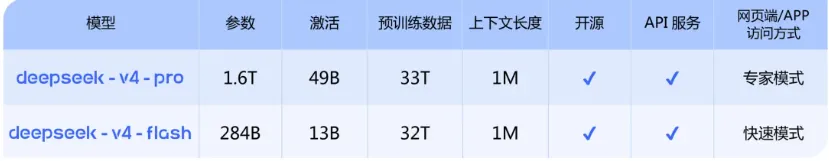
两大版本:Pro 和 Flash,各有所长
DeepSeek-V4 按大小分为两个版本,满足不同场景需求:
| 版本 | 定位 | 核心优势 | 适用场景 |
|---|---|---|---|
| DeepSeek-V4-Pro | 旗舰版 | Agent 能力最强,推理性能顶级,世界知识丰富 | 复杂 Agent 任务、高难度推理、专业知识问答 |
| DeepSeek-V4-Flash | 经济版 | 推理能力接近 Pro,速度更快,成本更低 | 简单 Agent 任务、日常对话、批量处理 |
两个版本都标配 1M 上下文,都支持思考模式(Reasoning Mode)。
DeepSeek-V4-Pro:性能比肩顶级闭源模型
1. Agent 能力大幅提升
重点来了:DeepSeek-V4-Pro 的 Agent 能力显著增强。
Agentic Coding 评测表现:
- 达到当前开源模型最佳水平
- 使用体验优于 Claude Sonnet 4.5
- 交付质量接近 Claude Opus 4.6 非思考模式
- 与 Opus 4.6 思考模式仍有一定差距
数据不会骗人:DeepSeek-V4 已成为 DeepSeek 公司内部员工使用的 Agentic Coding 模型。
Agent 相关评测全面优异:
- 代码任务表现提升
- 文档生成任务表现提升
- 针对 Claude Code、OpenClaw、OpenCode、CodeBuddy 等主流 Agent 产品进行了专项优化
2. 丰富的世界知识
DeepSeek-V4-Pro 在世界知识测评中:
- 大幅领先其他开源模型
- 仅稍逊于顶尖闭源模型 Gemini-Pro-3.1
简单说,就是知识储备已经接近 Google 的顶级模型了。
3. 世界顶级推理性能
在数学、STEM、竞赛型代码的测评中,DeepSeek-V4-Pro:
- 超越当前所有已公开评测的开源模型
- 取得了比肩世界顶级闭源模型的优异成绩
| 能力维度 | DeepSeek-V4-Pro | 对比 |
|---|---|---|
| 数学推理 | ✅ 超越所有开源模型 | 比肩 GPT-4o、Claude Opus |
| STEM 推理 | ✅ 超越所有开源模型 | 比肩顶级闭源模型 |
| 竞赛型代码 | ✅ 超越所有开源模型 | 比肩顶级闭源模型 |
| 世界知识 | ✅ 大幅领先开源模型 | 仅稍逊于 Gemini-Pro-3.1 |
| Agent 能力 | ✅ 开源模型最佳 | 优于 Sonnet 4.5,接近 Opus 4.6 |
DeepSeek-V4-Flash:更快捷高效的经济之选
DeepSeek-V4-Flash 的定位是速度和成本的平衡:
性能表现:
- 世界知识储备稍逊于 Pro
- 推理能力接近 Pro
- 简单 Agent 任务上与 Pro 旗鼓相当
- 高难度 Agent 任务上仍有差距
核心优势:
- 模型参数和激活更小
- 提供更加快捷、经济的 API 服务
- 同样支持 1M 上下文和思考模式
简单说,日常使用选 Flash,复杂任务选 Pro。
黑科技:全新注意力机制 + DSA 稀疏注意力
最让人眼前一亮的是 DeepSeek-V4 的结构创新。
核心技术突破
DeepSeek-V4 开创了一种全新的注意力机制:
- 在 token 维度进行压缩
- 结合 DSA 稀疏注意力(DeepSeek Sparse Attention)
- 实现了全球领先的长上下文能力
技术优势:
- 相比传统方法大幅降低计算需求
- 相比传统方法大幅降低显存需求
- 支持 1M 上下文成为标配
性能对比
| 对比维度 | DeepSeek-V4 | 传统方法 |
|---|---|---|
| 计算量 | ✅ 大幅降低 | ❌ 随上下文长度线性增长 |
| 显存容量 | ✅ 大幅降低 | ❌ 随上下文长度线性增长 |
| 上下文长度 | ✅ 1M 标配 | ❌ 通常 32K-128K |
从现在开始,1M(一百万)上下文将是 DeepSeek 所有官方服务的标配。
Agent 能力专项优化
DeepSeek-V4 针对主流 Agent 产品进行了适配和优化:
| Agent 产品 | 优化内容 |
|---|---|
| Claude Code | 代码任务、文档生成 |
| OpenClaw | Agent 框架适配 |
| OpenCode | 代码生成优化 |
| CodeBuddy | 编程助手优化 |
实际应用场景:
- 代码任务表现提升
- 文档生成任务表现提升
- 支持生成 PPT、报告等复杂文档
怎么用?三种方式任你选
1. 在线对话
登录官网 chat.deepseek.com 或官方 App,即可与最新的 DeepSeek-V4 对话,探索 1M 超长上下文记忆的全新体验。
2. API 调用
API 服务已同步更新,支持:
- OpenAI ChatCompletions 接口
- Anthropic 接口
调用方法:
       # base_url 不变,只需修改 model_name
model_name = "deepseek-v4-pro" # 或 "deepseek-v4-flash"核心参数:
- 最大上下文长度:1M
- 支持非思考模式和思考模式
- 思考模式支持
reasoning_effort参数设置思考强度(high/max)
使用建议:
- 复杂 Agent 场景建议使用思考模式
- 思考强度设置为 max
3. 本地部署
DeepSeek-V4 已同步开源,支持本地部署:
开源链接:
- Hugging Face: https://huggingface.co/collections/deepseek-ai/deepseek-v4
- ModelScope: https://modelscope.cn/collections/deepseek-ai/DeepSeek-V4
技术报告:
重要提醒:旧接口即将停用
请注意:旧有的 API 接口的两个模型名将于 2026 年 7 月 24 日停止使用:
deepseek-chat→ 将指向deepseek-v4-flash非思考模式deepseek-reasoner→ 将指向deepseek-v4-flash思考模式
建议尽快迁移到新的模型名。
能干啥?场景多到数不过来
| 应用场景 | 核心能力 | 实际价值 |
|---|---|---|
| Agentic Coding | 代码生成、调试、重构 | 提升开发效率,代码质量接近人类专家 |
| 文档生成 | PPT、报告、技术文档 | 自动化内容创作,节省大量时间 |
| 长文本分析 | 1M 上下文理解 | 分析整本书、完整代码库、长篇论文 |
| 复杂推理 | 数学、STEM、竞赛代码 | 解决高难度问题,辅助科研和学习 |
| 知识问答 | 丰富的世界知识 | 专业领域咨询,知识检索 |
| 思考模式 | 深度推理 | 处理复杂逻辑,提供详细思考过程 |
写在最后
DeepSeek-V4 的发布,标志着百万上下文普惠时代正式到来。
不再是「有个长上下文」就叫长上下文模型,而是要做到:1M 上下文标配 + 顶级推理能力 + 强大 Agent 能力 + 全面开源。
更重要的是,DeepSeek 这次不仅放出了模型,还提供了完整的 API 服务和开源权重。开发者可以直接上手,不用等。
从 Agent 能力来看,DeepSeek-V4-Pro 已经达到了优于 Claude Sonnet 4.5,接近 Opus 4.6 非思考模式的水平。这意味着,开源模型在 Agent 领域已经可以和顶级闭源模型掰手腕了。
从技术创新来看,全新的注意力机制 + DSA 稀疏注意力,让 1M 上下文不再是奢侈品,而是标配。计算和显存需求的大幅降低,意味着更多开发者可以用上超长上下文能力。
AGI 的未来,可能比我们想象的来得更快。
更多文章