
GLM-4.7 最新发布|Coding Agent 更稳:概览与快速使用(transformers / vLLM / SGLang / Thinking)
GLM-4.7 最新发布能力概览与快速上手:聚焦 Coding Agent(多语言代码生成/终端任务)、工具调用与复杂推理,并提供 transformers 推理示例、vLLM/SGLang 本地部署(OpenAI 风格 API)及 Thinking/Preserved Thinking 参数建议。
本文发布于 270 天前,内容可能已过时,请注意甄别。
如果你最近在关注“代码智能体 / Coding Agent”,那 GLM-4.7 这波更新就值得看一眼。
按 Hugging Face README 的说法,它这次的重点很明确:
- 写代码更能交付:多语言 Agentic Coding、终端任务更稳
- 更会用工具:工具调用能力提升,适合跑工作流
- 推理更强:复杂推理与数学能力拉升
下面我按“教程/指南”的方式,把你最关心的点一次讲清楚(并给出能直接照抄的命令/代码)。
你会得到什么(先看这个)
- 1 份可跑通的 transformers 最小示例:先把模型跑起来
- 2 套本地服务化方案:vLLM / SGLang 启动命令直接照抄
- Thinking 模式开关说明:什么时候开、怎么按请求关闭
- 参数建议与踩坑清单:更稳、更少返工
适合谁看
- 想把
GLM-4.7接到你的IDE/Coding Agent(能改仓库、能跑命令) - 想在内网/本地部署一个 OpenAI 风格 API 给团队用
- 想要“工具调用 + 多轮任务”更稳定的模型方案
快速导航
- 先跑通:跳到「先跑起来:transformers 直接本地推理」
- 对外提供 API:跳到「想对外提供 API?用 vLLM / SGLang 本地服务化」
- 开关 Thinking:跳到「Thinking 模式怎么开/怎么关?(以及什么时候该开)」
3 分钟看懂:这次到底强在哪?
1) 代码智能体更稳:Agentic Coding + 终端任务
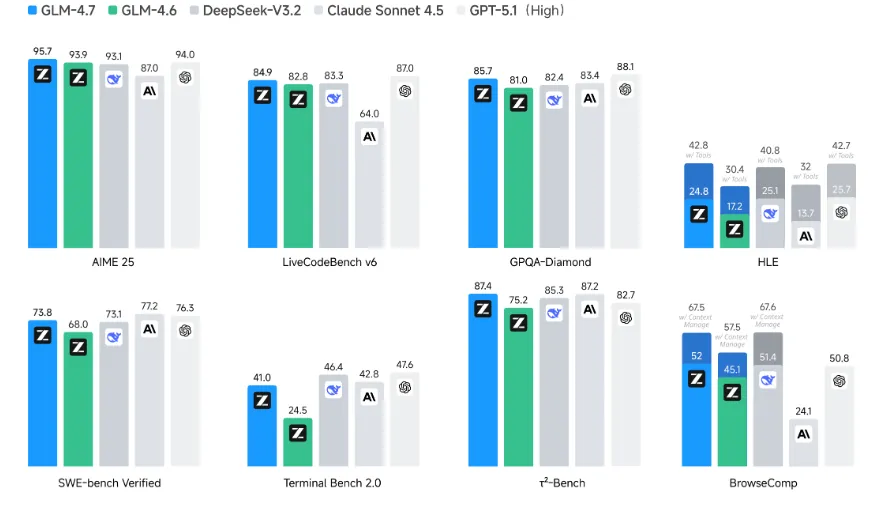
README 传递的关键信号是:GLM-4.7 在软件工程类基准与终端类任务上相较上一代有明显提升,而且更适合那种“先想清楚再动手”的多步骤流程。
放到日常开发里,你可以把它理解为:
- 更适合接入到“能改仓库、能跑命令、能读日志”的 Coding Agent 流程
- 在多轮任务里更不容易因为上下文漂移导致方案前后不一致
2) Vibe Coding 更好看:网页/幻灯片更像“成品”
如果你平时会让模型写前端页面、做简单 Demo、甚至生成演示内容,README 强调 GLM-4.7 在布局、尺寸、现代化视觉风格上更靠谱——一句话:更像能直接给人看的“成品”。
3) 工具调用更靠谱:更适合跑工作流
对于需要浏览网页、查资料、调内部系统的“工具链任务”,README 提到 GLM-4.7 的 Tool Using 有明显提升。实际接入时,建议你用 OpenAI 风格的工具描述格式(tool schema),这样兼容性最好。
4) Thinking 模式更灵活:Interleaved / Preserved / Turn-level
GLM-4.7 继续强化 Interleaved Thinking(响应与工具调用前的思考),并引入:
- Preserved Thinking:多轮 coding agent 场景中,自动保留思考块在多轮之间复用,减少信息丢失与推理重建带来的不一致
- Turn-level Thinking:同一会话里按轮次控制是否思考;简单任务可关闭以降低延迟与成本
更多说明:
先跑起来:transformers 直接本地推理
README 里提到与 transformers==4.57.3 配套使用。
下面这段就是“先跑通再说”的最小示例(你只需要准备 GPU/CPU 环境与依赖):
       import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_PATH = "zai-org/GLM-4.7"

messages = [
  {"role": "user", "content": "hello"}
]

tokenizer = AutoTokenizer.from_pretrained(MODEL_PATH)

inputs = tokenizer.apply_chat_template(
  messages,
  tokenize=True,
  add_generation_prompt=True,
  return_dict=True,
  return_tensors="pt",
)

model = AutoModelForCausalLM.from_pretrained(
  pretrained_model_name_or_path=MODEL_PATH,
  torch_dtype=torch.bfloat16,
  device_map="auto",
)

inputs = inputs.to(model.device)

generated_ids = model.generate(
  **inputs,
  max_new_tokens=128,
  do_sample=False,
)

output_text = tokenizer.decode(generated_ids[0][inputs.input_ids.shape[1] :])
print(output_text)
实战建议:
- 如果你要做“稳定复现”的任务,先用
do_sample=False(贪婪)或固定随机种子 - 大上下文(README 默认设置里 max new tokens 很大)会显著拉高显存与时延,按任务收敛配置
想对外提供 API?用 vLLM / SGLang 本地服务化
README 说明:vLLM 与 SGLang 需要使用它们的 main 分支(或 nightly/dev 镜像) 才能良好支持 GLM-4.7。
1) vLLM:安装与启动(照抄版)
Docker:
docker pull vllm/vllm-openai:nightlypip(README 强调必须使用 pypi 官方 index,且安装 nightly wheel):
pip install -U vllm --pre --index-url https://pypi.org/simple --extra-index-url https://wheels.vllm.ai/nightly启动服务(README 示例,包含 tool/reasoning parser 与自动工具选择):
       vllm serve zai-org/GLM-4.7-FP8 \
  --tensor-parallel-size 4 \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 1 \
  --tool-call-parser glm47 \
  --reasoning-parser glm45 \
  --enable-auto-tool-choice \
  --served-model-name glm-4.7-fp8
要点解释(便于你按环境改参数):
--tensor-parallel-size:多卡张量并行规模,按 GPU 数量与显存决定--served-model-name:对外暴露的模型名,便于网关/SDK 管理--tool-call-parser/--reasoning-parser:面向工具调用与思考块解析的适配器参数
2) SGLang:安装与启动(照抄版)
Docker:
docker pull lmsysorg/sglang:dev启动服务(README 示例):
       python3 -m sglang.launch_server \
  --model-path zai-org/GLM-4.7-FP8 \
  --tp-size 8 \
  --tool-call-parser glm47 \
  --reasoning-parser glm45 \
  --speculative-algorithm EAGLE \
  --speculative-num-steps 3 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 4 \
  --mem-fraction-static 0.8 \
  --served-model-name glm-4.7-fp8 \
  --host 0.0.0.0 \
  --port 8000
注意:上面参数偏“高性能推理”取向,落地时你需要结合:
- GPU 显存
- 并发量
- 是否需要 speculative decoding
Thinking 模式怎么开/怎么关?(以及什么时候该开)
1) 推荐:多轮 Agentic 任务开启 Preserved Thinking
README 建议:对于多轮 agentic 任务(例如 τ²-Bench、Terminal Bench、SWE-bench 多步骤修复),优先开启 Preserved Thinking。
SGLang 支持通过配置开启(README 示例):
       "chat_template_kwargs": {
  "enable_thinking": true,
  "clear_thinking": false
}
含义:
enable_thinking: true:开启 thinkingclear_thinking: false:不清理 thinking,跨轮保留(更适合长任务)
2) 想更快更省:按请求关闭 Thinking
README 说明:vLLM 与 SGLang 在发送请求时默认开启 thinking;如果你希望对某些轻量请求关闭,可以在请求里加:
extra_body={"chat_template_kwargs": {"enable_thinking": False}}实战建议:
- 写代码/跑流程/多工具链:默认开启 thinking
- 简单问答/格式化/翻译:可以关闭 thinking 提升吞吐
参数怎么配更稳:默认 vs 评测取向
README 给了两组常用参数(这里用“建议区间”的方式复述,方便你对齐自己的 SDK/网关参数名):
默认设置(大多数任务)
temperature: 1.0top_p: 0.95max_new_tokens: 131072
终端与软件工程评测取向(更稳)
temperature: 0.7top_p: 1.0max_new_tokens: 16384
τ²-Bench 取向(更“定型”)
temperature: 0max_new_tokens: 16384
落地建议(更像“工程默认值”):
- 真正跑生产时,
max_new_tokens不要盲目上到 131072;先按业务输出长度设置上限 - 对“必须稳定交付”的任务(修 bug、改代码),优先降低随机性(降低
temperature或关闭采样)
工具调用接入提示(少踩坑)
README 强调:vLLM / SGLang 都支持 tool calling,并建议使用 OpenAI 风格的工具描述格式。
工程实践里常见的两点:
- 工具 schema 约束要严格:参数类型、必填字段要明确
- 工具返回要可追溯:返回结果尽量包含
source、id、timestamp,便于多轮任务的引用与复盘
常见坑与排查清单(建议收藏)
- 框架版本:vLLM / SGLang 需要 main/nightly/dev,版本不对会出现无法加载或行为异常
- FP8 权重:示例里多处使用
GLM-4.7-FP8,请确认你的硬件与推理框架支持 FP8 - Thinking 输出处理:如果你要把模型输出展示给用户,记得区分“思考块”和“最终回答”,避免把思考内容直接透出到 UI
- 多轮一致性:长任务建议开启
Preserved Thinking,并在 Agent 层做“任务状态摘要”以减少上下文膨胀
相关链接
- Hugging Face README:
- Thinking Mode 文档:
- 官方 GitHub:
更多文章







相关文章
暂无相关文章