GLM-5.2 今日正式开源:753B 参数打赢 GPT-5.5,成本只要 1/6
Z.ai(智谱 AI)今日正式开源旗舰模型 GLM-5.2,753B 参数 + 100 万 token 上下文 + MIT 协议,FrontierSWE 超越 GPT-5.5,成本只有 1/6。这是继 MiniMax M3 后,中国大模型开源的又一重磅炸弹
本文发布于 94 天前,内容可能已过时,请注意甄别。
今天,GLM-5.2 正式开源了
6月17日,Z.ai(原智谱 AI)正式开源旗舰大模型 GLM-5.2,MIT 协议,权重全开放。
这不是”有限开源”,不是”仅供研究”,而是完全商业可用、无国界限制。你可以在 Hugging Face、ModelScope 直接下载权重,爱怎么用怎么用。
核心数据直接上:
| 项目 | 数据 |
|---|---|
| 参数规模 | 753B(MoE 架构,单 token 激活 40B) |
| 上下文窗口 | 100 万 token(最大输出 12.8 万 token) |
| 开源协议 | MIT(最宽松的商业许可) |
| API 定价 | 输入 $1.4/百万 token,输出 $4.4/百万 token |
| 成本优势 | 仅为同级别闭源模型的 1/4 到 1/6 |
比 MiniMax M3 晚两周,但这个开源力度更狠——753B 参数的 MoE 模型,完全开放权重。
性能:FrontierSWE 超越 GPT-5.5
GLM-5.2 的定位很明确:长周期任务(Long-Horizon Tasks)+ 自主软件工程 Agent。
什么叫”长周期”?不是写个函数、改个 bug,而是连续数小时到数十小时的开源项目级开发任务——编译器优化、内核调试、多系统协同开发。
核心 Benchmark 数据:
1. 长周期工程级代码评测
| Benchmark | GLM-5.2 | GPT-5.5 | Claude Opus 4.8 |
|---|---|---|---|
| FrontierSWE | 74.4% | 72.6% | 75.1% |
| PostTrainBench | 34.3% | 28.4% | 37.2% |
| SWE-Marathon | 13.0 | - | 26.0 |
FrontierSWE 是评估 Agent 在长达数小时至数十小时的开源技术项目上的执行表现。GLM-5.2 达到 74.4%,超越 GPT-5.5 的 72.6%,与 Claude Opus 4.8 的差距只有 0.7%。
PostTrainBench 测试 Agent 能否通过训练提升小模型。GLM-5.2 得分 34.3%,领先 GPT-5.5 近 6 个百分点。
SWE-Marathon 是高难度的编译器、内核优化等系统级开发测试。GLM-5.2 得分 13.0,虽然与 Opus 4.8 的 26.0 还有差距,但相比同类开源模型(如 Gemini 3.1 Pro 的 4.0)保持明显优势。
2. 传统编程与通用能力测试
| Benchmark | GLM-5.2 | 前代 GLM-5.1 |
|---|---|---|
| Terminal-Bench 2.1 | 81.0 | 63.5 |
| SWE-bench Pro | 62.1 | 58.4 |
| MCP-Atlas | 76.8 | - |
| AIME 2026 | 99.2 | - |
Terminal-Bench 2.1 得分 81.0,成为首个在该评测中突破 80% 的开源权重模型。
MCP-Atlas(工具调用机制测试)得分 76.8,领先 GPT-5.5 的 75.3。
AIME 2026(数学竞赛测试)得分 99.2,在复杂数学逻辑推理上表现出色。
3. 盲测竞技场(Arena)表现
- LMArena 编码性能盲测:GLM-5.2 超越 Claude Opus 4.7 和 4.8,排名世界第二
- Design Arena 设计编程评测:击败 Claude Fable 5,排名世界第一
这是开源模型第一次在盲测中打赢顶级闭源模型。
技术:1M 上下文 + IndexShare 架构优化
GLM-5.2 的技术升级主要集中在三个方向:
1. 实用的 1M 无损上下文(Solid 1M Context)
上下文窗口从前代 GLM-5.1 的 20 万 token 提升至 100 万 token,最大单次输出可达 12.8 万 token。
关键不只是”长”,而是”实用”。Z.ai 针对 1M 上下文进行了大规模的 Agent 训练,覆盖了代码库实现、自动化研究、性能优化和复杂调试等混乱且漫长的 Agent 轨迹。
在处理超长文本和多系统工程时,GLM-5.2 的理解和连贯性更加稳定。不是”能读 100 万 token”,而是”读懂 100 万 token 并且能干活”。
2. 硬件与架构优化:IndexShare
长上下文的痛点是计算资源消耗过大。Z.ai 提出了 IndexShare 机制:
- 通过在每 4 个稀疏注意力层(Sparse Attention Layers)中复用同一个轻量级索引器(Indexer)
- 在 1M 上下文长度下,成功将每个 token 的计算量(FLOPs)降低了 2.9 倍
- 改进了用于猜测解码(Speculative Decoding)的多 Token 预测(MTP)层,使 Token 的接受长度提升了多达 20%
简单说:用 1/3 的算力干同样的事。
3. 灵活的思考深度(Flexible Effort)
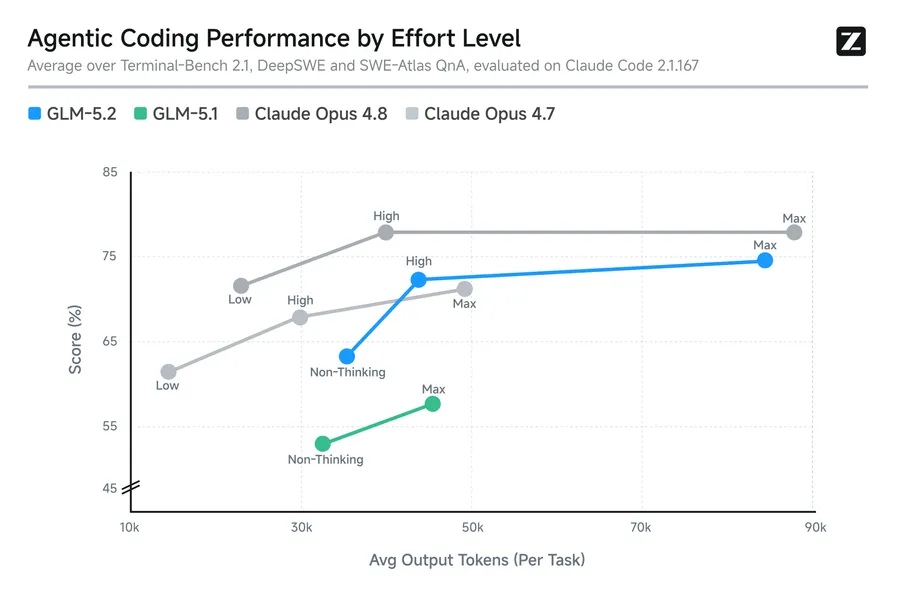
支持在调用时自定义思考深度级别(包括 High 和 Max 模式)。对于复杂、多步骤的编码任务,选择 Max 模式可以通过消耗更多的计算时间(和 Token)换取更高的推理正确率。
这是给开发者的”调节阀”:简单任务快速跑,复杂任务慢慢想。
生态:已接入主流工具链
GLM-5.2 的开源不是”扔个权重文件就跑路”,而是配套了完整的工具链支持:
本地运行支持
已完成对主流本地推理框架的适配:
- transformers
- vLLM
- SGLang
- xLLM
- ktransformers
- Ollama
下载权重就能跑,不用自己造轮子。
工具接入
支持无缝集成至当前主流的代码 Agent 框架:
- Claude Code
- OpenCode
- Cline
- Z.ai 官方的 ZCode 桌面端
开发者可以直接把 GLM-5.2 当成”替换芯片”,插进现有工作流。
定价:1/6 的成本打同样的仗
API 官方定价:
- 输入 $1.4/百万 token
- 输出 $4.4/百万 token
对比闭源模型:
- GPT-5.5:输入约 $8/百万 token,输出约 $24/百万 token
- Claude Opus 4.8:输入约 $10/百万 token,输出约 $30/百万 token
GLM-5.2 的成本只有它们的 1/4 到 1/6。
关键是,性能不是 1/6,是持平甚至反超。
这不是”便宜没好货”,这是”好货还便宜”。
为什么现在开源?
GLM-5.2 的开源时间点很微妙:
- 6月12日:Anthropic 最强模型 Claude Fable 被美国政府强制下线
- 6月13日:智谱宣布 GLM-5.2 即将开源
- 6月17日:GLM-5.2 正式开源,权重全开放
Z.ai 的官方口号是:“GLM-5.2 is Fully Open, Frontier Intelligence Belongs to Everyone.”
这不只是产品发布,这是一种立场:你们封锁,我们开放;你们建墙,我们拆墙。
结合上周 MiniMax M3 的开源,中国大模型厂商的策略已经很清楚:
- 不跟你比”谁的模型最强”(短期追不上)
- 跟你比”谁的生态最大”(开源是捷径)
- 用成本优势 + 开放策略,快速占领开发者心智
闭源模型的护城河是技术优势,但技术优势会被追平。开源模型的护城河是生态锁定,而生态一旦建立,就很难被撼动。
谁会用 GLM-5.2?
这个模型的目标用户很明确:
1. 需要长周期 Agent 的开发者
- 自动化代码库重构
- 多系统协同开发
- 复杂性能优化
- 长时间自主调试
2. 预算有限但要求不低的团队
- 成本只有闭源模型的 1/6
- 性能持平甚至反超 GPT-5.5
- 可以本地部署,数据不出域
3. 想基于大模型做二次开发的研究者
- MIT 协议,无限制
- 可以蒸馏、微调、商业化
- 权重全开放,架构可研究
最后说一句
GLM-5.2 的开源,加上两周前 MiniMax M3 的开源,中国大模型的路线已经很清楚了:
不跟你玩闭源护城河的游戏,直接掀桌子。
OpenAI、Anthropic、Google 组建”模型保护联盟”,把模型权重当芯片一样保护。智谱和 MiniMax 选择全面开源,把选择权交给开发者。
两种策略,现在还看不出输赢。但有一点可以确定:
当性能差距缩小到 10% 以内,成本差距是 6 倍,而且一个开源一个闭源——开发者会用脚投票。
一年后,我们会知道谁赌对了。
相关资源:
更多文章