Jina Embeddings v5 Omni:一个模型,把文本、图片、视频和音频放进同一个向量空间
Jina Embeddings v5 Omni 是 Jina AI 的多模态嵌入模型,把文本、图片、视频、音频映射到同一个向量空间,适合跨模态搜索、聚类、推荐和多模态 RAG。
本文发布于 126 天前,内容可能已过时,请注意甄别。
Embedding 模型过去大多只擅长一种媒体:文本归文本,图片归图片,音频和视频还要先拆解、转写、再拼回检索系统。
Jina Embeddings v5 Omni 的核心定位更直接:一个多模态嵌入模型,把文本、图片、视频、音频映射到同一个向量空间。
它真正值得看的地方,不是“又支持了几种输入”,而是让不同媒体之间可以直接做语义比较:用一句话找图片,用图片找视频,用音频线索找相关文档。
30 秒速览
- 支持模态:文本、图片、视频、音频
- 核心能力:把不同媒体映射到同一个 embedding 空间
- 搜索方式:可以用文本搜图片、用图片搜视频、用音频找相关内容
- 模型形态:Jina v5 系列的 Omni 多模态 embedding 模型
- 模型版本:提供
small和nano两个版本,兼顾效果和成本 - 适用任务:语义搜索、聚类、去重、相似推荐、多模态 RAG 检索
一句话总结:它把 embedding 从“文本向量”推进到“多媒体统一语义向量”。
它真正解决的不是“能不能识别媒体”,而是“能不能统一比较”
很多多模态系统表面上很先进,底层其实很碎。
比如一个知识库里同时有产品文档、教程视频、直播录音、设计图、截图和客服对话。传统做法通常是:文本走文本索引,图片走图像向量,视频拆成帧,音频先 ASR,再把各路结果拼起来。
问题来了:
- 多个索引之间怎么统一打分?
- 图片和文本的相似度怎么比较?
- 视频片段和文档段落怎么一起排序?
- 一个用户只输入一句话,系统到底该查哪几路?
Jina Embeddings v5 Omni 的价值就在这里。它不是单纯让模型“能看图、能听音频”,而是让这些媒体进入同一个可比较的空间。
这意味着你可以把一段文字、一张图片、一段视频、一个音频片段都变成向量,然后直接计算相似度、做聚类、做推荐、做跨模态召回。
为什么“同一个向量空间”很重要?
向量检索最怕的一件事,是相似度没有统一语义。
文本模型算出来的 0.82,和图片模型算出来的 0.82,不一定是同一种意义。你要把它们混在一起排序,就需要额外做校准、融合和重排。
Jina Embeddings v5 Omni 的思路更直接:不同媒体进入同一个 embedding 空间,让跨模态比较本身变得自然一些。
这对三类场景特别有用:
- 素材库搜索:输入“雨夜霓虹街道”,直接找图片、视频、音频素材
- 企业知识库:一句问题同时召回文档、会议录音、培训视频和截图
- 内容平台推荐:用用户喜欢的视频,找相关文字、图片和音频内容
以前这些场景都能做,但会堆很多胶水代码。现在关键变化是:底层可以更像一条管线,而不是四套系统强行拼接。
它和 Jina Embeddings v5 Text 是什么关系?
jina-embeddings-v5-omni 不是推倒重来,而是建立在 Jina Embeddings v5 的文本能力之上。
换句话说,它延续了 v5 系列在文本 embedding 上的基础,然后扩展到图片、视频和音频。
这点很重要。因为多模态检索最怕“文本能力被牺牲”。如果一个模型能处理音视频,但文本搜索质量明显下降,企业知识库和 RAG 系统就很难放心换。
Jina 这次的路线更像是:先稳住文本语义空间,再把其他媒体对齐进来。
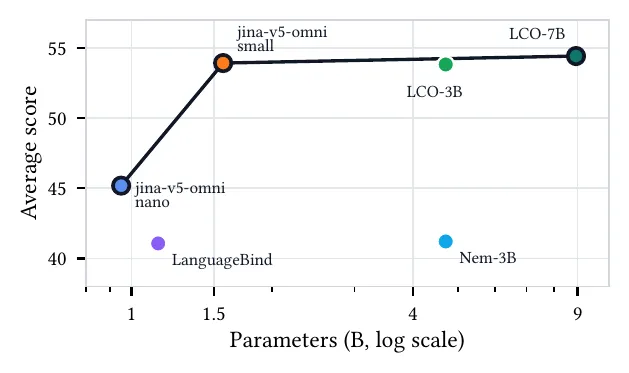
small 和 nano:不是所有场景都需要大模型
Jina Embeddings v5 Omni 提供了 small 和 nano 两个方向。
这背后的判断很现实:多模态检索不只是实验室 Benchmark,最终要跑在真实索引、真实并发、真实成本里。
- small 更适合对效果要求更高的生产场景
- nano 更适合成本敏感、延迟敏感、边缘部署或大规模批处理
尤其是音频、视频这种媒体,一旦进入大规模库,embedding 成本会迅速放大。一个模型效果再好,如果处理 100 万条视频素材时成本失控,工程上也很难落地。
所以这次值得看的不是“有没有最大模型”,而是它有没有给搜索系统留下可选空间。
它可以接什么系统?
模型本身输出的是 embedding,后面可以接向量数据库、推荐系统、素材管理系统、企业搜索或 RAG 管线。
关键不在某个具体数据库,而在于模型把不同媒体压进同一个语义空间,让下游系统能用统一向量表示来组织内容。
这会让下游系统更容易做几件事:
- 跨模态相似度计算
- 多媒体内容聚类
- 图片/视频/音频去重和近似匹配
- 文本问题召回多媒体证据
- 多模态 RAG 的第一阶段检索
可以怎么用?
比较实用的落地路径是这样的:
- 内容入库:把文本、图片、音频、视频片段都转成 embedding
- 写入向量库:把向量和元数据一起写入向量数据库、推荐系统或自建检索系统
- 统一查询:用户可以输入文本,也可以上传图片或音频作为查询
- 结果融合:从同一个向量空间召回,再结合时间、权限、类型、热度做重排
- RAG 接入:把召回结果交给大模型生成答案或摘要
一个典型例子: 用户问“上周产品发布会里提到的那个绿色仪表盘截图在哪?”
系统可以同时召回:
- 发布会视频片段
- 会议录音转写
- 相关 PPT 截图
- 产品文档中的对应段落
这就是多模态 embedding 真正有用的地方:不是为了炫技,而是为了减少用户在不同媒体之间来回翻找的成本。
但它不是万能搜索引擎
这里也要说清楚。
Jina Embeddings v5 Omni 解决的是“统一表示”和“跨模态召回”,不是完整应用系统的全部问题。
你仍然需要处理:
- 视频切片策略
- 音频分段策略
- 文档权限过滤
- 业务字段筛选
- 排序和重排
- 垃圾内容和重复内容清理
- 向量召回后的答案可信度
尤其在 RAG 场景里,embedding 只决定“召回什么”,不保证“回答一定正确”。如果索引内容本身质量很差,模型只会更快地把垃圾找出来。
不舒服但真实的一句话是:多模态 embedding 能统一语义空间,但救不了烂数据治理。
我的看法
Jina Embeddings v5 Omni 最值得关注的地方,不是它支持了四种媒体,而是它把 embedding 模型从“单模态向量”往“统一多媒体语义空间”推进了一步。
对开发者来说,这意味着一个模型可以覆盖更多媒体类型。
对企业来说,这意味着文档、视频、图片、音频这些原本分散的资产,有机会用统一向量表示重新组织起来。
对 RAG 来说,这意味着知识库不再只能依赖文字,培训视频、会议录音、产品截图、设计稿都可以成为可检索上下文。
如果你正在做企业搜索、素材库、知识库、客服系统或多模态 RAG,这个模型值得认真看。它不是把搜索问题一次性解决掉,但它确实把“不同媒体统一向量表示”这件事,推到了更可落地的位置。
相关链接
更多文章