Agent 为什么总点错?微软 Phi-Ground-Any 专门补 GUI 定位这只眼睛
Agent 老是点错,不一定是推理差,更可能是看不准。微软 Phi-Ground-Any 把 GUI 定位做成 4B 开源模型:1680x1008 大画布、直接输出点击点,专门补 Computer Use Agent 的最后一公里。
本文发布于 130 天前,内容可能已过时,请注意甄别。
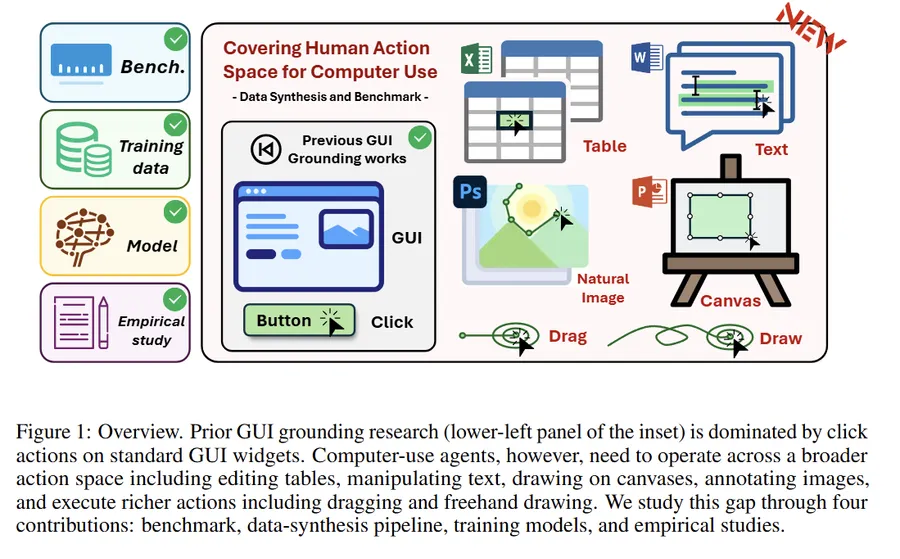
你如果做过 Computer Use Agent,大概率见过这种崩溃现场:任务理解没问题,步骤规划也像模像样,结果一到真正点击按钮、选菜单、找输入框,成功率就开始往下掉。
很多时候,问题不是 Agent 不会想,而是它看不准。
这次要介绍的模型 Phi-Ground-Any,官方定位更准确地说,是一个面向 GUI grounding 的 4B 专用模型。它不是完整桌面助手,也不是通用看图聊天模型,而是负责根据文字指令在截图里找交互目标,并输出更适合点击执行的坐标结果。
先说结论:Phi-Ground-Any 适合谁?
如果你在做下面这些东西,这模型很值得看:
- 浏览器 Agent
- 桌面自动化助手
- RPA / 测试自动化
- 无障碍辅助工具
- 任何“先看屏幕,再点击操作”的多模态系统
如果你只是想找一个泛用视觉模型来聊天、OCR、总结图片,它就不一定是最合适的。
Phi-Ground-Any 的价值不在“什么都懂”,而在 能不能更稳地找到该点的位置。
它到底是什么?
Phi-Ground-Any 的公开版本是 Microsoft Phi-Ground-Any-4B,基于 microsoft/Phi-3.5-vision-instruct 微调,固定输入分辨率是 1680x1008。
这个数字很关键。因为它不是上一版 Phi-Ground 的 1008x672,而是更大的 5x3 tile canvas,也就是官方注释里写的 336 * 5 乘 336 * 3。
它的核心任务也很单一: 给它一张截图,再给一句直接指令,比如“Chrome 地址栏”“提交按钮”“左侧设置图标”,模型输出的不是一大段解释,而是点击点坐标:
<x>4823</x><y>3120</y>这里的数值是 相对坐标,范围在 [0, 10000],需要你自己还原成真实像素坐标。
和 Phi-Ground 相比,Any 版进步在哪里?
这点得说清楚。
和 Phi-Ground 相比,Phi-Ground-Any 更贴近 实际点击场景。前者更偏传统 grounding 路线,强调定位区域;Any 版则把输入、提示词和输出都往 Agent 执行链路上继续推进:
- 输入画布更大:
1680x1008 - 指令格式更直接:不需要“describe the element”那层包装
- 输出是点击点
<x><y>,而不是先找一个矩形框再自己猜点哪里
这意味着它更适合接在真正的 Computer Use Agent 后面,当一个“找落点”的专用模块。
说白了,Phi-Ground-Any 更像在解决“你到底该点哪一个像素附近”,而不是“这个区域大概在哪里”。
和 Phi-Ground 简单对比:进步到底在哪?
如果只看名字,Phi-Ground-Any 很像 Phi-Ground 的小改版,但从使用方式看,它更像是朝真实 Agent 点击链路又走了一步。
最直接的几个差别是:
- 输入画布更大:
Phi-Ground更偏1008x672,Phi-Ground-Any提到的是1680x1008,对小图标、小按钮、小文字更友好 - 输出更贴近执行:前一代更偏 bounding box 思路,
Phi-Ground-Any直接给<x><y>点击点,少了一层“框出来后再猜点哪里” - 提示词更短:
Phi-Ground更像“描述元素再定位”,Phi-Ground-Any更偏直接 instruction 输入,离真实 Agent 调用更近 - 落点导向更强:它不是只回答“区域在哪”,而是更强调“下一步该点哪里”
如果把这件事说得更直白一点:Phi-Ground 更像在做 GUI 元素框选能力,Phi-Ground-Any 更像在把这项能力往 实际点击执行 方向继续推。
为什么这类模型比很多人想的重要?
微软 Research 在文章里说得很直白:GUI grounding 就是 Agent 的感知系统。
你前面推理得再漂亮,只要落点不稳定,整条链路就会不断重试、误触、跑偏。很多人以为 Agent 不够聪明,真实情况往往是它最后那一下手眼协调太差。
这也是我觉得 Phi-Ground-Any 真正有价值的地方。它不是再去卷“最强通用多模态模型”,而是把 Agent 成败里那个经常被低估、但代价很高的模块单独拉出来优化。
不舒服但真实的一句话是:很多自动化系统失败,不是因为不会规划,而是因为点错一次就把整个流程带崩了。
它的成绩到底怎么样?
微软官方 Research 文章给出的结论很明确:Phi-Ground 模型家族在 10B 以下同类模型里,在五个 GUI grounding 基准上都做到 SOTA。
文章里点了两个更容易理解的指标:
- ScreenSpot-Pro:55%
- UI-Vision:36.2%
微软也同时提醒了一个很现实的背景:当前 grounding 模型整体成功率大约也就 65% 左右,离“日常可依赖”还差得远。
所以别把它理解成“已经完美了”。更准确的说法是:Phi-Ground-Any 把 Agent 里最脆弱的一环,往前推了一步,而且方向是对的。
它为什么更适合点击场景?
使用时有几个点很值得记。
第一,大画布。Phi-Ground-Any 用的是 1680x1008,而不是更小的输入尺寸。对 GUI 这种场景来说,小图标、小按钮、小文字本来就难,画布一小更容易丢细节。
第二,instruction-first。官方明确写了要把指令放前面,再喂图。原因很简单:模型先知道“我到底在找什么”,再看屏幕,命中率通常更高。
第三,直接输出点击点。这点特别关键。很多 grounding 流程会先给你一个框,再让上层自己决定点中心、点边缘还是点某个子区域。Phi-Ground-Any 直接输出 <x><y>,这对真实点击链路更省事。
第四,它更像 Agent 子模块,而不是端到端主模型。这是优点,不是缺点。专用模块的价值就在于把最后一公里做稳。
使用前先记住三个坑
1. 分辨率不是建议,是硬要求
输入格式要求很明确:图像要处理成 1680x1008。
也就是:
target_width, target_height = 336 * 5, 336 * 3如果你拿原始截图直接丢进去,效果很可能会明显变差。
2. 提示词别自作聪明乱改
Phi-Ground-Any 是 直接吃用户指令 的,不需要再套一层 “The description of the element:” 这种包装。
官方示例就是:
       <|user|>
{instruction}<|image_1|>
<|end|>
<|assistant|>
这不是可有可无的小细节。Grounding 模型通常很吃输入格式,提示词写花了,反而更差。
3. 输出不是现成像素坐标
它输出的 <x> 和 <y> 是 相对坐标,范围在 0 到 10000,对应的是 padding 后的大画布。
你还要自己做两步:
- 先映射回 1680x1008 的 padded image
- 再按
reshape_ratio还原回原始截图坐标
如果这一步算错,模型明明找对了,你的点击还是会偏。
怎么快速跑起来?
官方示例使用的依赖大概是这些:
       pip install \
  flash_attn==2.5.8 \
  numpy==1.24.4 \
  Pillow==10.3.0 \
  requests==2.31.0 \
  torch==2.3.0 \
  torchvision==0.18.0 \
  transformers==4.43.0 \
  accelerate==0.30.0
下面这段是一个最小可跑示例,重点保留它真实需要的输入格式:
       from PIL import Image
import re
import torch
from transformers import AutoProcessor, AutoModelForCausalLM

MODEL_ID = "microsoft/Phi-Ground-Any"
TARGET_WIDTH, TARGET_HEIGHT = 336 * 5, 336 * 3  # 1680 x 1008
SCALE = 10000.0


def process_image(img: Image.Image):
    img_ratio = img.width / img.height
    target_ratio = TARGET_WIDTH / TARGET_HEIGHT

    if img_ratio > target_ratio:
        new_width = TARGET_WIDTH
        new_height = int(new_width / img_ratio)
    else:
        new_height = TARGET_HEIGHT
        new_width = int(new_height * img_ratio)

    reshape_ratio = new_width / img.width
    img = img.resize((new_width, new_height), Image.LANCZOS)

    canvas = Image.new("RGB", (TARGET_WIDTH, TARGET_HEIGHT), (255, 255, 255))
    canvas.paste(img, (0, 0))
    return canvas, reshape_ratio


def to_original_pixel(x_rel, y_rel, reshape_ratio):
    px = (x_rel / SCALE) * TARGET_WIDTH / reshape_ratio
    py = (y_rel / SCALE) * TARGET_HEIGHT / reshape_ratio
    return px, py

instruction = "Search box"
prompt = f"""<|user|>
{instruction}<|image_1|>
<|end|>
<|assistant|>"""

original_image = Image.open("screen.png").convert("RGB")
image, reshape_ratio = process_image(original_image)

processor = AutoProcessor.from_pretrained(MODEL_ID, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    trust_remote_code=True,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

inputs = processor(text=prompt, images=image, return_tensors="pt")
inputs = {k: v.to(model.device) if hasattr(v, "to") else v for k, v in inputs.items()}

outputs = model.generate(**inputs, max_new_tokens=64)
result = processor.batch_decode(outputs, skip_special_tokens=True)[0]
print(result)

x_match = re.search(r"<x>\s*(-?\d+(?:\.\d+)?)\s*</x>", result)
y_match = re.search(r"<y>\s*(-?\d+(?:\.\d+)?)\s*</y>", result)

if x_match and y_match:
    x_rel = float(x_match.group(1))
    y_rel = float(y_match.group(1))
    px, py = to_original_pixel(x_rel, y_rel, reshape_ratio)
    print(px, py)
真正接到 Agent 系统里时,通常还要再配一层:
- 上层大模型负责任务理解和规划
- Phi-Ground-Any 负责找点击点
- 执行器负责 click / type / scroll
- 状态检查模块负责确认页面有没有真的变化
这套拆法看起来没那么炫,但真实系统里往往更稳。
我的看法
Phi-Ground-Any 这种模型真正提醒人的地方是:Agent 要变强,不一定先换更大的脑子,先把眼睛和手练准更有用。
过去很多人把“看屏幕”这件事想得太轻,以为多模态模型接上截图就自然会点。现实完全不是这样。GUI 定位本身就是一门独立工种,它吃数据、吃画布、吃格式、也吃很多工程细节。
如果你正在做浏览器 Agent、桌面助手、自动化测试、无障碍辅助,这个模型很值得认真看一遍。
它不是万能答案,但它解决的是一个非常贵、非常常见,也非常容易被低估的问题:别让 Agent 因为点不准,输掉整条工作流。
相关链接
更多文章