
CV 6 min read
Qwen-Image-Edit-2511 上手:更稳的一致性、更少的漂移,还把 LoRA 直接“塞进模型”
Qwen-Image-Edit-2511 是 Qwen-Image-Edit-2509 的增强版本,主打更稳的角色一致性、更少的图像漂移,并把部分社区 LoRA 能力“内置化”。本文用偏口语但技术向的方式,带你快速了解它能做什么、怎么用 diffusers 跑起来,以及哪些场景最值。
本文发布于 269 天前,内容可能已过时,请注意甄别。
这模型到底是干嘛的?
如果你对“图像编辑”模型的期待是:
- 我给一张图,告诉它“把帽子换成红色、把背景变成夜景”,它就能改,而且别把人脸改到亲妈不认。
- 我给两张图,让它把 A 图的角色和 B 图的道具/风格“融合得合理一点”。
那 Qwen-Image-Edit-2511 就是来干这个的。
官方描述里,它是 Qwen-Image-Edit-2509 的增强版,重点是:一致性更强、漂移更少,并且对一些实用场景(工业设计、几何推理)做了增强。
2511 相比 2509,主要升级点
- 更少的 image drift(图像漂移)
- 你让它“改局部”,它不太会顺手把全图风格/细节带跑。
- 更强的角色一致性(character consistency)
- 尤其是人像/角色编辑时,身份特征更容易保住。
- 集成 LoRA 能力(integrated LoRA capabilities)
- 一些社区里很受欢迎的 LoRA 效果,被官方挑选后“直接整合进底座”,不需要你额外挂 LoRA 也能吃到对应能力。
- 工业设计生成更强(industrial design generation)
- 偏工程/产品图那种需求,稳定性更好。
- 几何推理更强(geometric reasoning)
- 比如生成辅助线、结构更规整的几何关系等。
你可以怎么用它(两条路)
- 在线体验:去 Qwen Chat 里选 Image Editing
- 本地推理:用
diffusers跑(下面给你最短可用版)
如果你是“要进工作流”的那类人:
- 本地推理的好处是你能更可控地做批处理、做参数扫、做集成。
Quick Start:diffusers 跑起来
官方建议安装最新 diffusers(直接从 GitHub 装):
pip install git+https://github.com/huggingface/diffusers然后用 QwenImageEditPlusPipeline:
       import os
import torch
from PIL import Image
from diffusers import QwenImageEditPlusPipeline

pipeline = QwenImageEditPlusPipeline.from_pretrained(
    "Qwen/Qwen-Image-Edit-2511",
    torch_dtype=torch.bfloat16,
)
print("pipeline loaded")

pipeline.to("cuda")
pipeline.set_progress_bar_config(disable=None)

image1 = Image.open("input1.png")
image2 = Image.open("input2.png")

prompt = (
    "The magician bear is on the left, the alchemist bear is on the right, "
    "facing each other in the central park square."
)

inputs = {
    "image": [image1, image2],
    "prompt": prompt,
    "generator": torch.manual_seed(0),
    "true_cfg_scale": 4.0,
    "negative_prompt": " ",
    "num_inference_steps": 40,
    "guidance_scale": 1.0,
    "num_images_per_prompt": 1,
}

with torch.inference_mode():
    output = pipeline(**inputs)
    output_image = output.images[0]
    output_image.save("output_image_edit_2511.png")
    print("image saved at", os.path.abspath("output_image_edit_2511.png"))
参数怎么理解(别太纠结版)
num_inference_steps- 越高通常越稳/越细,但更慢。官方示例是
40,你可以从28~40起步。
- 越高通常越稳/越细,但更慢。官方示例是
true_cfg_scale- 更像“听话程度”的旋钮,但不是越大越好。示例
4.0是一个偏稳的起点。
- 更像“听话程度”的旋钮,但不是越大越好。示例
guidance_scale- 这里示例是
1.0,说明它不靠传统那种拉很高的 guidance 来“硬掰”。
- 这里示例是
这代最值得关注的:一致性增强
官方 showcase 强调了两件事:
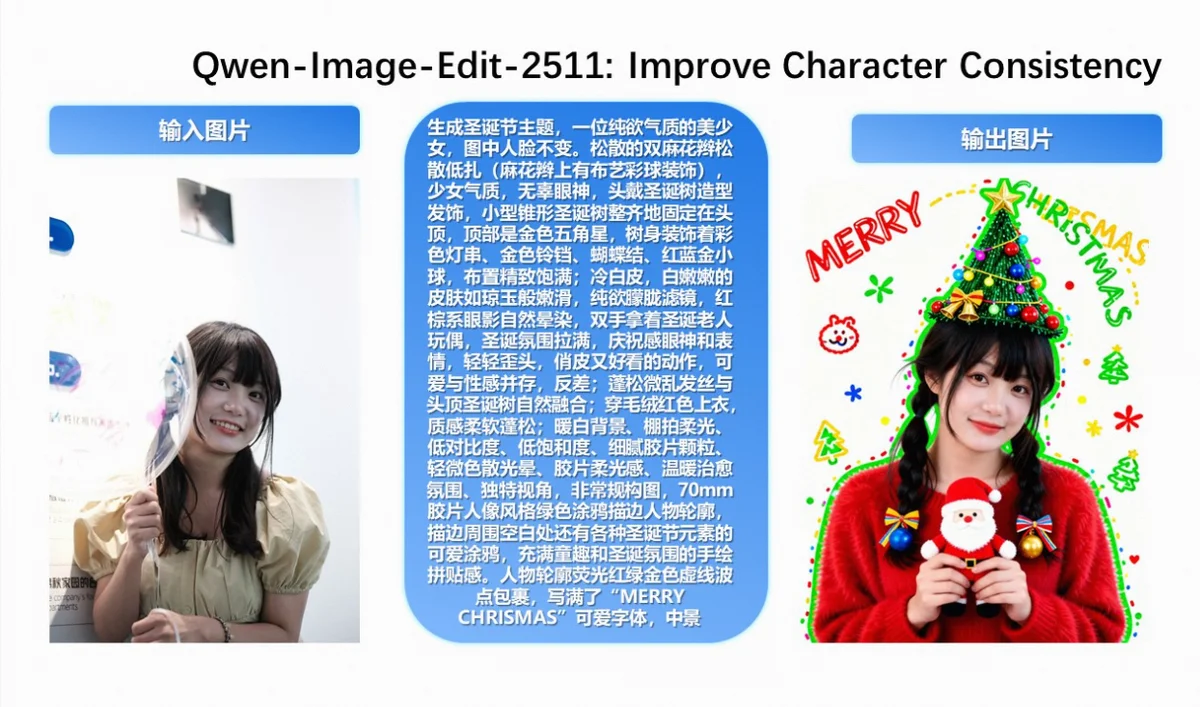
- 单人一致性更稳:拿一张人像做“想象式编辑”(比如换造型、换风格),依然能保留身份特征。
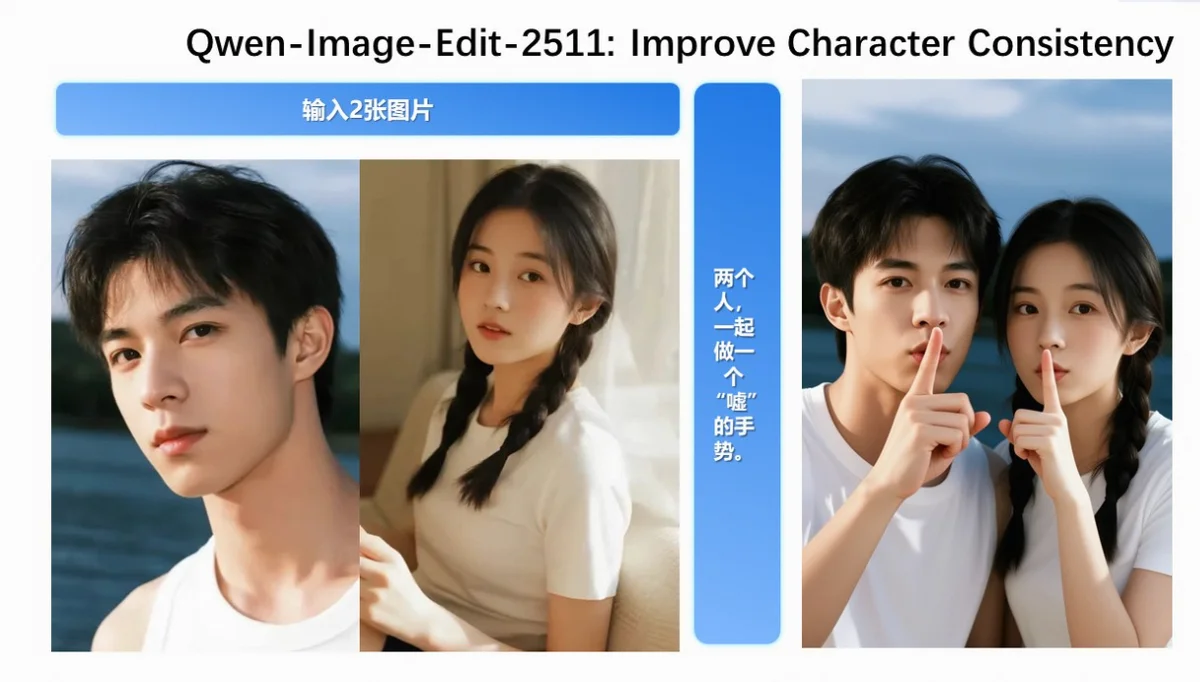
- 多人一致性更稳:群像/合影这种最容易翻车的场景,它更能把“多个主体”处理得像同一张照片里的一家人。
你如果做:
- IP 角色连续创作
- 角色海报批量换文案/换元素
- 多图融合(两张人像合成一张合照)
会明显更吃这一点。
“内置 LoRA”意味着什么?
这句话很关键:Qwen-Image-Edit-2511 把部分社区 LoRA 直接集成进底座模型。
直观好处:
- 你不用额外找 LoRA、下载、挂载、调权重,就能直接得到一些增强能力(比如更好的光照控制)。
直观风险:
- 你会发现“底座的风格/偏好”更强了:有时候更好用,有时候你反而需要在 prompt 上更明确地约束风格。
工业设计与几何推理:不是噱头,是真刚需
很多图像编辑模型在“艺术图”上看起来很强,但一到下面这些就开始翻车:
- 产品外观要规整
- 结构要对称
- 线条要干净
- 角度透视不要乱
官方把 industrial design 和 geometric reasoning 单独拎出来讲,基本就说明:这代更想去覆盖“设计/工程图”这类更挑剔的需求。
如果你在做:
- 产品概念图迭代
- 工业部件材质替换
- 设计图上加辅助线/标注线
这类偏 CV 工程向的活儿,2511 会更对味。
资源与参考
- Hugging Face
- ModelScope(README / 权重)
- Tech Report(Qwen-Image)
- Demo(HF Spaces)
更多文章

ZCode 说只是做索引,可它翻开的不止当前代码

OpenClaw 2.0 发布:Agent 终于能把没做完的事接着做

“牛来”揭面:智谱 GLM-5.3-Flash 匿名期跑出 44 万亿 Token
GLM-5.3 发布:基座没换,智谱把后训练推到数十倍任务环境

DeepSeek Harness 开源:把 Agent 的整套运行底座拆开了

FFmpeg 9.0 “Lei” 发布:这个版本号,纪念一位中国音视频开发者

DeepSeek-V4-Flash 正式上线:性能超过 GLM,逼近 Opus 4.8,价格更狠

GPT-5.6 Luna 直接降价 80%:百万 Token 输出只要 1.2 美元
Kimi K3 真开源了:2.8T 模型如何只激活 104B 参数?