SAM-Audio技术解析:从计算机视觉到音频分离的跨模态突破
本文深入解析了Meta发布的SAM-Audio音频分离模型,详细对比其与计算机视觉SAM模型的技术架构、提示机制和应用场景。从多模态提示支持、音频分离原理到实际应用示例,全面分析这一跨模态突破如何将"分割一切"理念从视觉领域扩展到音频处理,为音频AI技术发展开辟新的可能性。
本文发布于 275 天前,内容可能已过时,请注意甄别。
前言
继 Meta 在计算机视觉领域推出革命性的 Segment Anything Model (SAM) 后,Facebook Research 团队再次发力,将”分割一切”的理念扩展到音频领域,推出了 SAM-Audio。这一创新将视觉分割的成功经验迁移到音频处理中,实现了”隔离任何声音”的目标,为音频处理领域带来了全新的基础模型范式。
项目概览
核心能力
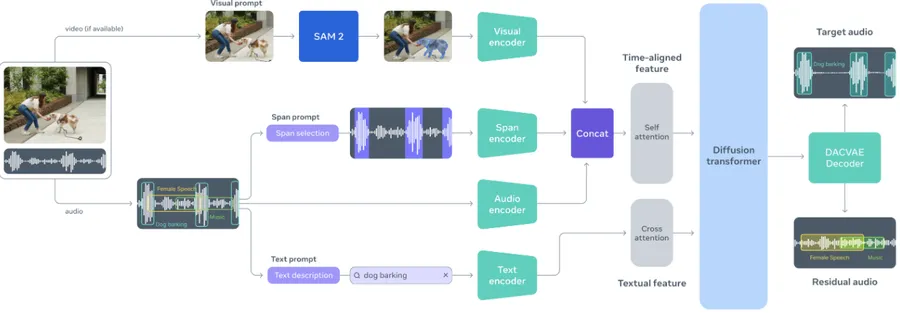
SAM-Audio 是一个音频基础模型,能够使用文本、视觉或时间提示从复杂的音频混合中分离出特定声音。其核心特性包括:
- 多模态提示支持:支持自然语言描述、视觉线索和时间跨度三种提示方式
- 高精度音频分离:能够从复杂音频环境中精确提取目标声音
- 灵活的应用场景:适用于语音分离、音乐制作、音效处理等多个领域
技术架构
SAM-Audio 采用了与视觉 SAM 相似的架构设计思路,但针对音频数据的特点进行了专门优化:
       from sam_audio import SAMAudio, SAMAudioProcessor
import torchaudio

# 模型加载和初始化
model = SAMAudio.from_pretrained("facebook/sam-audio-large")
processor = SAMAudioProcessor.from_pretrained("facebook/sam-audio-large")
model = model.eval().cuda()

# 基本音频分离流程
def audio_separation_demo(audio_file, description):
    """
    演示基本的音频分离功能

    参数:
        audio_file: 音频文件路径
        description: 目标声音的文本描述
    """
    # 数据预处理
    batch = processor(
        audios=[audio_file],
        descriptions=[description],
    ).to("cuda")

    # 执行分离
    result = model.separate(batch)

    # 保存结果
    sample_rate = processor.audio_sampling_rate
    torchaudio.save("target.wav", result.target.cpu(), sample_rate)      # 目标声音
    torchaudio.save("residual.wav", result.residual.cpu(), sample_rate)  # 其他声音

    return result
与计算机视觉 SAM 的对比分析
核心理念对比
| 特性 | CV SAM | SAM-Audio |
|---|---|---|
| 目标任务 | 图像中的物体分割 | 音频中的声音分离 |
| 输入模态 | 图像数据 | 音频数据 |
| 提示方式 | 点击、框选、文本 | 文本、视觉、时间跨度 |
| 输出结果 | 分割掩码 | 分离的音频流 |
| 应用领域 | 计算机视觉、图像编辑 | 音频处理、语音分离 |
技术实现对比
1. 数据表示差异
CV SAM:
- 处理二维图像数据 (H × W × C)
- 空间相关性强,像素间存在明确的邻接关系
SAM-Audio:
- 处理一维时序音频数据
- 时间相关性强,频域特征重要
- 需要考虑频谱特征和时间动态
2. 提示机制创新
文本提示对比:
       # CV SAM 的文本提示(概念示意)
cv_prompt = "一只猫"  # 用于指导视觉分割

# SAM-Audio 的文本提示
audio_prompt = "一个男人在说话"  # 用于指导音频分离
processor(audios=[audio], descriptions=[audio_prompt])
SAM-Audio 独有的多模态提示:
       # 1. 视觉提示:使用视频帧和掩码
processor(
    audios=[video],
    descriptions=[""],
    masked_videos=processor.mask_videos([frames], [mask])
)

# 2. 时间跨度提示:指定目标声音出现的时间范围
processor(
    audios=[audio],
    descriptions=["汽车喇叭声"],
    anchors=[[["+", 6.3, 7.0]]]  # 6.3秒到7.0秒之间
)
3. 架构设计对应关系
| 组件 | CV SAM | SAM-Audio |
|---|---|---|
| 编码器 | Vision Transformer | 音频编码器(可能基于Transformer) |
| 提示编码器 | 点/框/文本编码器 | 文本/视觉/时间编码器 |
| 解码器 | 掩码解码器 | 音频分离解码器 |
| 输出 | 分割掩码 | 目标音频 + 残余音频 |
技术特性深度解析
1. 多尺度模型支持
SAM-Audio 提供了三种不同规模的模型,满足不同性能需求:
       # 模型规模对比
models = {
    "small": "facebook/sam-audio-small",    # 轻量级,适合资源受限环境
    "base": "facebook/sam-audio-base",      # 平衡性能与效率
    "large": "facebook/sam-audio-large"     # 最佳性能,需要更多计算资源
}

# 专门优化的视觉提示版本
visual_optimized_models = {
    "small-tv": "facebook/sam-audio-small-tv",
    "base-tv": "facebook/sam-audio-base-tv",
    "large-tv": "facebook/sam-audio-large-tv"
}
2. 性能评估指标
根据官方评估,各模型在不同音频类型上的主观评分(满分5分):
| 模型 | 通用音效 | 语音 | 说话人 | 音乐 | 乐器(野外) | 乐器(专业) |
|---|---|---|---|---|---|---|
| small | 3.62 | 3.99 | 3.12 | 4.11 | 3.56 | 4.24 |
| base | 3.28 | 4.25 | 3.57 | 3.87 | 3.66 | 4.27 |
| large | 3.50 | 4.03 | 3.60 | 4.22 | 3.66 | 4.49 |
3. 实际应用示例
       class AudioSeparationPipeline:
    """完整的音频分离处理流水线"""

    def __init__(self, model_name="facebook/sam-audio-large"):
        """初始化音频分离流水线"""
        self.model = SAMAudio.from_pretrained(model_name)
        self.processor = SAMAudioProcessor.from_pretrained(model_name)
        self.model = self.model.eval().cuda()

    def separate_speech(self, audio_file, speaker_description="男性声音"):
        """语音分离:从多人对话中提取特定说话人"""
        batch = self.processor(
            audios=[audio_file],
            descriptions=[speaker_description],
        ).to("cuda")

        result = self.model.separate(batch)
        return result

    def separate_music_instrument(self, audio_file, instrument="钢琴"):
        """音乐分离:从乐队演奏中提取特定乐器"""
        batch = self.processor(
            audios=[audio_file],
            descriptions=[f"{instrument}演奏"],
        ).to("cuda")

        result = self.model.separate(batch)
        return result

    def time_based_separation(self, audio_file, description, start_time, end_time):
        """基于时间的音频分离"""
        batch = self.processor(
            audios=[audio_file],
            descriptions=[description],
            anchors=[[["+", start_time, end_time]]]
        ).to("cuda")

        result = self.model.separate(batch)
        return result

# 使用示例
pipeline = AudioSeparationPipeline()

# 语音分离
speech_result = pipeline.separate_speech("meeting_recording.wav", "女性发言人")

# 音乐分离
music_result = pipeline.separate_music_instrument("orchestra.wav", "小提琴")

# 时间段分离
time_result = pipeline.time_based_separation("street_noise.wav", "汽车声", 5.0, 10.0)
最后
SAM-Audio 的推出标志着音频处理领域进入了一个新时代。通过将计算机视觉中成功的”分割一切”理念迁移到音频领域,Meta 再次展现了其在 AI 基础模型方面的技术实力。这一创新不仅为音频处理提供了强大的工具,也为跨模态AI技术的发展开辟了新的可能性。
从技术角度来看,SAM-Audio 与 CV SAM 在架构设计和核心理念上保持了高度的一致性,同时针对音频数据的特点进行了专门的优化。这种设计思路为未来开发其他模态的”Segment Anything”模型提供了宝贵的经验。
随着技术的不断完善和应用场景的扩展,SAM-Audio 有望成为音频处理领域的重要基础设施,推动相关产业的发展和创新。对于开发者和研究人员而言,这一工具的开源发布无疑将加速音频AI技术的普及和应用。
本文基于 SAM-Audio 官方文档和技术资料撰写,旨在为读者提供全面的技术解析和应用指导。
更多文章