
AIGC 4 min read
腾讯混元 HY-MT 1.5:33语种翻译模型,小参数大效果
腾讯混元 HY-MT 1.5 翻译模型使用教程,WMT25冠军升级版,支持33语种互译,1.8B小模型效果媲美7B,附部署代码和Docker镜像
本文发布于 262 天前,内容可能已过时,请注意甄别。
这是什么?
腾讯混元最近开源了 HY-MT 1.5 翻译模型,简单说就是一个专门做翻译的大模型。它能翻译 33 种语言,还支持粤语、繁体中文这些方言。
最厉害的是,这个模型是 WMT25(机器翻译领域的顶级比赛)冠军模型的升级版,翻译质量相当能打。
项目地址:https://github.com/Tencent-Hunyuan/HY-MT
有什么亮点?
小模型也能打
HY-MT 提供了两个版本:
| 版本 | 参数量 | 说明 |
|---|---|---|
| HY-MT1.5-1.8B | 18亿 | 轻量版,适合手机端、实时翻译 |
| HY-MT1.5-7B | 70亿 | 完整版,效果最好 |
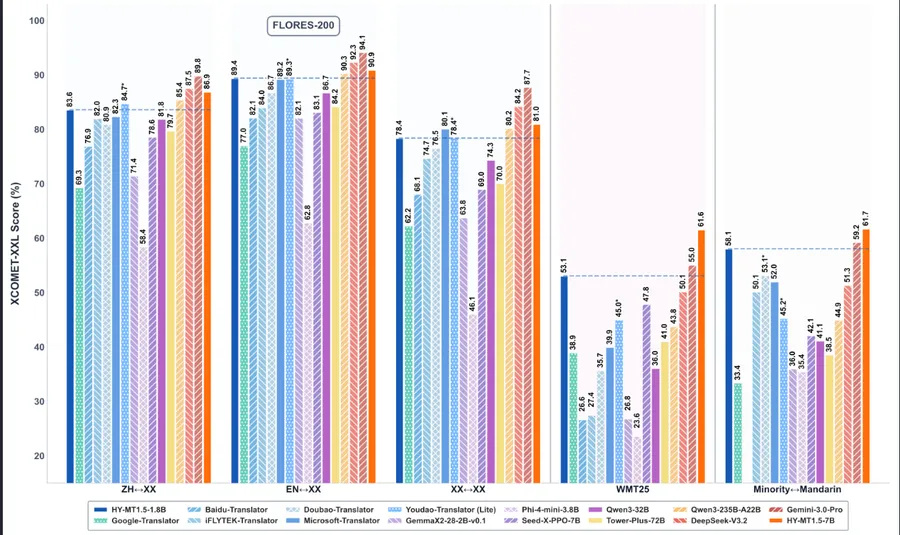
重点来了:1.8B 的小模型,效果居然跟 7B 差不多。参数量只有三分之一,但翻译质量几乎一样,这对想在手机或者边缘设备上跑翻译的开发者来说太友好了。
三个实用新功能
- 术语干预 - 可以指定专业词汇怎么翻译,比如医学、法律术语
- 上下文翻译 - 结合上下文理解,翻译更连贯
- 带格式翻译 - 保留原文的排版格式,翻文档很方便
语言覆盖
支持中英日韩法德俄阿拉伯语等 33 种语言互译,另外还有 5 种民汉/方言(粤语、繁体中文等)。
模型下载
腾讯提供了多种量化版本,显卡不够的也能跑:
       HY-MT1.5-1.8B          # 基础版
HY-MT1.5-1.8B-FP8      # FP8 量化
HY-MT1.5-1.8B-GPTQ-Int4 # Int4 量化,显存占用最小

HY-MT1.5-7B            # 标准版
HY-MT1.5-7B-FP8        # FP8 量化
HY-MT1.5-7B-GPTQ-Int4  # Int4 量化
怎么用?
Transformers 推理
最简单的方式,装好 transformers 就能跑:
       from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "tencent/HY-MT1.5-7B"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

prompt = "将以下中文翻译成英文:人工智能正在改变我们的生活方式。"

inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(
    **inputs,
    top_k=20,
    top_p=0.6,
    repetition_penalty=1.05,
    temperature=0.7,
    max_new_tokens=256
)

result = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(result)官方推荐的参数配置:top_k=20, top_p=0.6, repetition_penalty=1.05, temperature=0.7
Docker 一键部署
懒得折腾环境的话,直接用官方 Docker 镜像:
       docker pull hunyuaninfer/hunyuan-7b:hunyuan-7b-trtllm

docker run -d --gpus all \
  -p 8000:8000 \
  hunyuaninfer/hunyuan-7b:hunyuan-7b-trtllm
支持的推理框架
除了 Transformers,还支持这些主流框架:
- TensorRT-LLM - 追求极致性能
- vLLM - 高并发服务部署
- SGLang - 灵活的推理引擎
想微调怎么办?
用 LLaMA-Factory 框架就行:
       # 单机训练
llamafactory-cli train examples/hy-mt/sft.yaml

# 多机分布式
torchrun --nproc_per_node=8 \
  llamafactory-cli train examples/hy-mt/sft.yaml
比如你想针对医学文档优化翻译效果,准备好数据集微调一下就可以了。
适合什么场景?
- 实时翻译 App - 1.8B 版本够用,跑得快
- 文档翻译 - 带格式翻译保留排版
- 专业领域 - 术语干预确保准确性
- 翻译服务 - 7B + vLLM 高吞吐部署
- 多语言客服 - 33 种语言即时互译
去哪下载?
- Hugging Face: tencent/HY-MT1.5-7B
- ModelScope: 魔搭社区搜索 HY-MT
- GitHub: Tencent-Hunyuan/HY-MT
小结
HY-MT 1.5 作为 WMT 冠军模型的升级版,几个优势很明显:
- 1.8B 小模型效果逼近 7B,部署友好
- 术语干预、上下文翻译这些功能很实用
- 33 种语言 + 方言,覆盖面广
- 多种量化版本和推理框架支持
如果你在做多语言相关的项目,这个模型值得试试。
更多文章

ZCode 说只是做索引,可它翻开的不止当前代码

OpenClaw 2.0 发布:Agent 终于能把没做完的事接着做

“牛来”揭面:智谱 GLM-5.3-Flash 匿名期跑出 44 万亿 Token
GLM-5.3 发布:基座没换,智谱把后训练推到数十倍任务环境

DeepSeek Harness 开源:把 Agent 的整套运行底座拆开了

FFmpeg 9.0 “Lei” 发布:这个版本号,纪念一位中国音视频开发者

DeepSeek-V4-Flash 正式上线:性能超过 GLM,逼近 Opus 4.8,价格更狠

GPT-5.6 Luna 直接降价 80%:百万 Token 输出只要 1.2 美元
Kimi K3 真开源了:2.8T 模型如何只激活 104B 参数?