Qwen3.5:9B击败120B,0.8B手机跑视频的全系MoE模型
Qwen3.5 MoE系列(0.8B-397B)采用Gated DeltaNet混合注意力。9B超越120B模型,0.8B可在手机处理视频。百万token上下文,原生多模态,支持201种语言。
本文发布于 200 天前,内容可能已过时,请注意甄别。
阿里巴巴通义千问团队于 2026 年 2 月 16 日正式发布 Qwen3.5 系列模型,这是通义千问家族的最新旗舰。旗舰模型 Qwen3.5-397B-A17B 拥有 3970 亿总参数,但每次前向传播仅激活 170 亿参数,在推理、编程、多模态理解等多个维度上达到了开源模型的新高度。
3 月 2 日,Qwen3.5 小模型系列正式开源——Qwen3.5-0.8B、2B、4B、9B 四款模型全部采用 Apache 2.0 许可证发布。其中 9B 模型在 GPQA Diamond 上以 81.7 的得分击败了参数量是其 13.5 倍的 OpenAI GPT-OSS-120B(71.5),而 0.8B 模型甚至可以在手机上处理视频——这是 Qwen3.5 架构优势在小模型上的完美体现。
Qwen3.5 不是简单的版本迭代——它在架构层面进行了根本性创新。通过引入 Gated DeltaNet 混合注意力机制 和 原生多模态训练,Qwen3.5 以远低于竞争对手的激活参数量,实现了与 GPT-5.2、Claude Opus 4.5 等顶级闭源模型相当甚至超越的性能。
架构革新:为什么 Qwen3.5 与众不同
Gated DeltaNet:突破注意力瓶颈
传统 Transformer 的自注意力机制有一个致命弱点:计算复杂度随序列长度呈二次方增长。这意味着处理 100 万 token 的成本是处理 10 万 token 的 100 倍,这在实际应用中几乎不可行。
Qwen3.5 的解决方案是 Gated DeltaNet——一种融合了循环神经网络思想的线性注意力变体:
| 特性 | 传统注意力 | Gated DeltaNet |
|---|---|---|
| 计算复杂度 | O(n²) 二次方 | 接近 O(n) 线性 |
| 百万token支持 | 成本极高 | 可行且高效 |
| 长距离依赖 | 需要全量注意力 | 通过门控状态更新 |
| 内存占用 | 与序列长度成正比 | 近似恒定 |
3:1 混合比例设计
Qwen3.5 并没有完全抛弃传统注意力,而是采用了精妙的 3:1 混合架构:
60层 = 15 × (3 × [Gated DeltaNet → MoE] → 1 × [标准注意力 → MoE])- 每 4 个 Transformer 块:3 个使用 Gated DeltaNet(线性注意力),1 个使用标准全注意力
- 线性注意力负责高效处理长距离上下文
- 标准注意力确保关键位置的精确信息检索
这种设计首次在 Qwen3-Next(2025 年 9 月)中引入,经过 NVIDIA 工程团队的验证后,在 Qwen3.5 中全面投产。
稀疏 MoE:用 17B 做 397B 的事
| 参数 | 数值 |
|---|---|
| 总参数量 | 397B |
| 激活参数量 | 17B(仅 4.3%) |
| 总专家数 | 512 |
| 激活专家数 | 10 路由 + 1 共享 |
| 专家中间维度 | 1024 |
| 隐藏维度 | 4096 |
| 层数 | 60 |
共享专家机制是 Qwen3.5 MoE 的独特之处:一个专用的稠密 MLP 处理每个 token,捕获通用特征,提升训练稳定性和整体性能。其余 10 个路由专家则根据输入动态分配,处理特定领域的知识。
原生多模态:告别”拼装”时代
过去几年,行业的标准做法是先训练一个语言模型,再外接视觉编码器。Qwen3.5 彻底抛弃了这种模式——从零开始在文本、图像和视频上同时训练。
为什么原生多模态更好?
| 方面 | 拼接式多模态 | 原生多模态(Qwen3.5) |
|---|---|---|
| 训练方式 | 先训练语言,再加视觉 | 文本+图像+视频同时训练 |
| 模态融合 | 后期对齐,存在信息损失 | 早期融合,无缝理解 |
| 训练效率 | 视觉训练效率较低 | 接近 100% 文本训练效率 |
| 模型数量 | 需要独立的VL模型 | 单一统一模型 |
这使得 Qwen3.5 在视觉基准上全面超越了前代独立的 Qwen3-VL 模型系列。
视觉-语言基准表现
| 基准测试 | Qwen3.5 | 类别 |
|---|---|---|
| MMMU | 85.0 | STEM/综合推理 |
| MMMU-Pro | 79.0 | 高级多模态推理 |
| MathVision | 88.6 | 数学视觉推理 |
| MathVista (mini) | 90.3 | 数学可视化 |
| OmniDocBench | 90.8 | 文档理解 |
| OCRBench | 93.1 | OCR 识别 |
| VideoMME (带字幕) | 87.5 | 视频理解 |
| MLVU | 86.7 | 多语言视频理解 |
语言基准:80% 维度超越 GPT-5.2
Qwen3.5-397B-A17B 在主要评估中表现极为强劲:
数学与推理
| 基准测试 | Qwen3.5 | 说明 |
|---|---|---|
| AIME26 | 91.3 | 数学竞赛级推理 |
| HMMT Feb 25 | 94.8 | 高难度数学竞赛 |
| MMLU-Pro | 87.8 | 综合知识推理 |
| GPQA Diamond | 88.4 | 研究生级别问答 |
| C-Eval | 93.0 | 中文综合评测 |
编程与智能体
| 基准测试 | Qwen3.5 | 说明 |
|---|---|---|
| SWE-bench Verified | 76.4 | 真实软件工程任务 |
| LiveCodeBench v6 | 83.6 | 实时编程评测 |
| IFBench | 76.5 | 指令遵循 |
| LongBench v2 | 63.2 | 长上下文理解 |
据报道,Qwen3.5 在 80% 的评估类别中超越了 GPT-5.2 和 Claude Opus 4.5。
201 种语言,25 万词汇表
| 对比项 | Qwen3 | Qwen3.5 |
|---|---|---|
| 支持语言数 | 119 | 201 |
| 词汇表大小 | 150K | 250K |
| 多token预测 | 不支持 | 支持(推理成本降低 10-60%) |
多 token 预测(Multi-Token Prediction)允许模型在单步中”猜测”多个后续 token,配合推测解码(Speculative Decoding),可以在 201 种语言中大幅降低推理成本。
上下文窗口:原生 262K,可扩展至 100 万
| 特性 | 规格 |
|---|---|
| 原生上下文 | 262,144 tokens |
| 扩展上下文 | 1,010,000 tokens(YaRN 缩放) |
| Qwen3.5-Plus | 默认 100 万 token 上下文 |
相比 Qwen3-Max,Qwen3.5 在不同场景下的性能提升:
| 场景 | 加速倍数 |
|---|---|
| 256K token 长上下文 | 19 倍 |
| 标准工作流(32K) | 8.6 倍 |
| 内存占用(FP8) | 减少 50% |
| 运行成本 | 降低 60% |
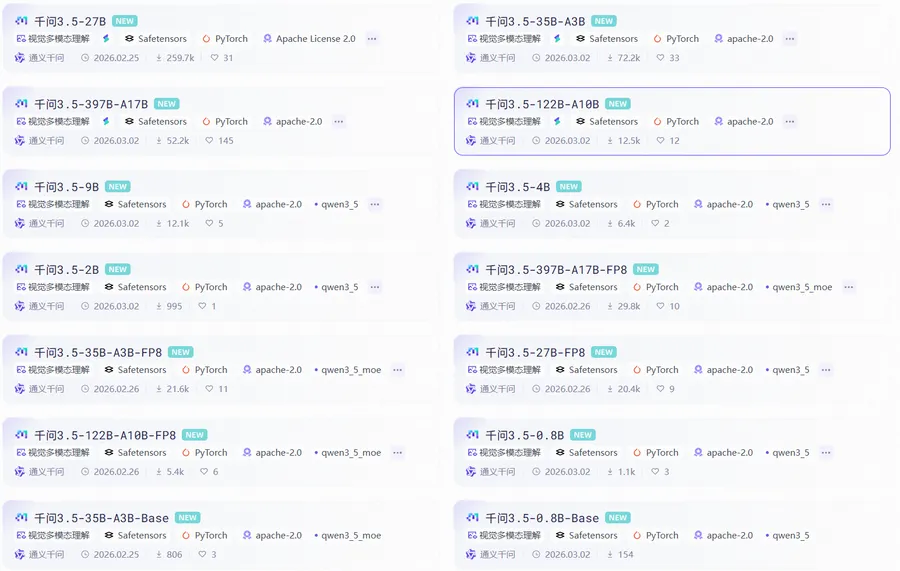
模型家族:从 0.8B 到 397B 全覆盖
Qwen3.5 采用分批发布策略:
| 发布日期 | 模型 | 类型 |
|---|---|---|
| 2026.02.16 | Qwen3.5-397B-A17B | MoE 旗舰 |
| 2026.02.24 | Qwen3.5-122B-A10B | MoE 中型 |
| 2026.02.24 | Qwen3.5-35B-A3B | MoE 中型 |
| 2026.02.24 | Qwen3.5-27B | Dense 中型 |
| 2026.03.02 | Qwen3.5-9B | 小模型旗舰 |
| 2026.03.02 | Qwen3.5-4B | 轻量级智能体 |
| 2026.03.02 | Qwen3.5-2B | 边缘设备 |
| 2026.03.02 | Qwen3.5-0.8B | 手机/IoT |
值得关注的是,Qwen3.5-35B-A3B 在核心基准上击败了 Qwen3-235B-A22B——纯粹通过更好的架构、数据和 RL 训练实现,而非堆叠参数。
3月2日重磅:小模型系列全面开源
2026 年 3 月 2 日,Qwen 团队一次性开源了 Qwen3.5-0.8B、2B、4B、9B 四款小模型。这不是简单的”大模型缩小版”——每一款都继承了 Qwen3.5 完整的 Gated DeltaNet 混合架构,拥有 262K 原生上下文窗口和原生多模态能力(文本 + 图像 + 视频)。
这是 AI 历史上第一次:0.8B 的模型能处理视频,4B 的模型能当多模态智能体,9B 的模型能全面超越上一代 30B 模型。
Qwen3.5-9B:紧凑型性能怪兽
9B 是小模型系列的旗舰,它最大的看点是已经缩小了与大型模型之间的差距。
对阵 GPT-OSS-120B(参数量是其 13.5 倍):
| 基准测试 | Qwen3.5-9B | GPT-OSS-120B | 差距 |
|---|---|---|---|
| GPQA Diamond | 81.7 | 71.5 | +10.2 |
| HMMT Feb 2025 | 83.2 | 76.7 | +6.5 |
| MMLU-Pro | 82.5 | 80.8 | +1.7 |
| MMMLU(多语言) | 81.2 | — | 领先 |
对阵 GPT-5-Nano:
| 基准测试 | Qwen3.5-9B | GPT-5-Nano | 差距 |
|---|---|---|---|
| MMMU-Pro | 70.1 | 57.2 | +12.9 |
| MathVision | 78.9 | 62.2 | +16.7 |
| OmniDocBench v1.5 | 87.7 | 55.9 | +31.8 |
对阵上一代 Qwen3-30B(参数量是其 3.3 倍):
| 基准测试 | Qwen3.5-9B | Qwen3-30B | 说明 |
|---|---|---|---|
| GPQA Diamond | 81.7 | 77.2 | 超越 |
| 指令遵循 | 91.5 | 88.9 | 超越 |
| LongBench v2 | 55.2 | 48.0 | 超越 |
硬件需求:BF16 精度下可在单张 RTX 3090(24GB)上运行;4-bit 量化后约 5GB 显存,RTX 3060 12GB 或 M1 Mac 即可流畅运行。
Qwen3.5-4B:轻量级智能体的惊人多模态基座
4B 模型的定位非常独特——它是目前同参数量级中最强的多模态智能体基座模型。
在仅需 8GB 显存的条件下,Qwen3.5-4B 同时支持:
| 能力 | 说明 |
|---|---|
| 262K 上下文 | 小模型中罕见的超长上下文 |
| 原生视觉理解 | 图像识别、文档OCR、图表分析 |
| 视频处理 | 原生视频理解能力 |
| 工具调用 | 支持 Function Calling |
| 思考模式 | 支持 Thinking Mode 深度推理 |
过去,4B 参数量的模型只能做基础文本任务。Qwen3.5-4B 打破了这个认知——它在功能完整度上接近大型模型,但硬件门槛极低。对于需要在消费级 GPU 上部署轻量级 AI Agent 的场景,这可能是目前最优选择。
Qwen3.5-0.8B / 2B:小巧、快速,为边缘而生
0.8B 和 2B 是为边缘设备和端侧部署而生的:
| 特性 | Qwen3.5-0.8B | Qwen3.5-2B |
|---|---|---|
| 目标设备 | 智能手机、IoT、嵌入式 | 边缘服务器、快速原型 |
| 多模态 | 原生支持图像+视频 | 原生支持图像+视频 |
| 上下文窗口 | 262K tokens | 262K tokens |
| 离线视频 | 支持(60秒/8FPS) | 支持 |
| 空间推理 | 支持 | 支持 |
| 电池友好 | 极低功耗 | 低功耗 |
关键突破:这是首次 0.8B 参数量的模型具备原生视频处理能力。在手机上实现离线视频摘要(最长 60 秒,8 FPS)、空间推理等功能,而不会过度消耗电池。
竞争格局对比
| 对比维度 | Qwen3.5 小模型 | Google Gemma 3 | Meta Llama 3.2 | Microsoft Phi-4-mini |
|---|---|---|---|---|
| 最小参数 | 0.8B | 1B | 1B | 14B |
| 原生多模态 | 全系列支持 | 部分支持 | 小模型仅文本 | 仅文本 |
| 上下文窗口 | 262K | 128K | 128K | 128K |
| 视频处理 | 全系列支持 | 部分支持 | 不支持 | 不支持 |
| 许可证 | Apache 2.0 | Apache 2.0 | Llama License | MIT |
智能体能力:为 Agent 时代而生
Qwen3.5 不只是一个聊天模型,它是为智能体范式设计的:
| 能力 | 说明 |
|---|---|
| 工具调用 | 原生 Function Calling 支持 |
| MCP 协议 | 支持 Model Context Protocol |
| 代码执行 | 内置代码解释器能力 |
| Agent 编排 | 支持多智能体协作框架 |
| 自适应思考 | Thinking Mode 深度推理 |
Thinking Mode(默认开启)
Qwen3.5 默认使用思考模式,生成格式为:
       <think>
...推理过程...
</think>

最终回答
推荐将 max_tokens 设置为 32,768 以上,复杂数学和编程任务建议 81,920。
部署指南
推荐框架
| 框架 | 适用场景 |
|---|---|
| SGLang | 生产环境推荐 |
| vLLM | 高吞吐服务 |
| KTransformers | CPU-GPU 异构计算 |
| Transformers | 开发调试 |
SGLang 部署示例
       python -m sglang.launch_server \
  --model-path Qwen/Qwen3.5-397B-A17B \
  --port 8000 \
  --tp-size 8 \
  --context-length 262144 \
  --reasoning-parser qwen3
vLLM 部署示例
       vllm serve Qwen/Qwen3.5-397B-A17B \
  --port 8000 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --reasoning-parser qwen3
纯文本模式(节省显存)
       vllm serve Qwen/Qwen3.5-397B-A17B \
  --port 8000 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --language-model-only
API 调用示例
       from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPTY"
)

# 文本对话
response = client.chat.completions.create(
    model="Qwen/Qwen3.5-397B-A17B",
    messages=[{"role": "user", "content": "解释量子计算的基本原理"}],
    max_tokens=81920,
    temperature=0.6,
    top_p=0.95,
    extra_body={"top_k": 20},
)

# 图像理解
response = client.chat.completions.create(
    model="Qwen/Qwen3.5-397B-A17B",
    messages=[{
        "role": "user",
        "content": [
            {"type": "image_url", "image_url": {"url": "https://example.com/image.jpg"}},
            {"type": "text", "text": "描述这张图片的内容"}
        ]
    }],
    max_tokens=81920,
)
推荐采样参数
| 参数 | Thinking 模式 | Non-Thinking 模式 |
|---|---|---|
| Temperature | 0.6 | 0.7 |
| Top-P | 0.95 | 0.8 |
| Top-K | 20 | 20 |
| Presence Penalty | 0.0 | 1.5 |
与竞争对手的全面对比
推理与知识能力
| 基准测试 | Qwen3.5 | GPT-5.2 | Claude Opus 4.5 |
|---|---|---|---|
| AIME26 | 91.3 | — | — |
| MMLU-Pro | 87.8 | — | — |
| GPQA Diamond | 88.4 | — | — |
| C-Eval | 93.0 | — | — |
| SWE-bench Verified | 76.4 | — | 80%+ |
| LiveCodeBench v6 | 83.6 | — | — |
据官方和第三方评测报告,Qwen3.5 在 80% 的评估维度上超越了 GPT-5.2 和 Claude Opus 4.5,但在 SWE-bench 等复杂软件工程任务上,Claude 仍保持领先。
视觉能力对比
在多模态方面,Qwen3.5 在 MMMU、MathVision、OCRBench 等基准上表现顶尖,但在部分视觉特定基准上仍略逊于 Gemini 3。
技术意义:注意力机制的新战场
Qwen3.5 的发布标志着大模型架构的几个重要转折:
- 稀疏 MoE 成为默认策略 —— 训练和部署数千亿密集参数的时代正在终结
- 线性注意力进入生产级 —— Gated DeltaNet 证明了线性注意力可以在不损失质量的情况下替代大部分标准注意力层
- 注意力机制成为新战场 —— 一年前的问题是”MoE 还是 Dense”,现在的分歧在于如何处理注意力:Qwen 选择 Gated DeltaNet,DeepSeek 选择 MLA,两条路线正在激烈竞争
- 原生多模态是未来方向 —— 单独训练视觉模型再拼接的方式将逐渐被淘汰
- 小模型不再”小” —— Qwen3.5-9B 击败 GPT-OSS-120B 证明架构创新比参数堆叠更重要,端侧 AI 的时代已经到来
开源协议与资源
- 许可证:Apache 2.0(完全开源商用)
- 模型下载:Hugging Face
- GitHub:QwenLM/Qwen3.5
- 官方 API:阿里云百炼
- 在线体验:Qwen Chat
- Qwen-Agent:GitHub
总结:Qwen3.5 通过 Gated DeltaNet 混合注意力 + 稀疏 MoE 的创新架构组合,在仅激活 17B 参数的条件下实现了接近甚至超越万亿参数模型的性能。3 月 2 日开源的小模型系列更是将这种架构优势推向极致——9B 击败 GPT-OSS-120B、4B 成为最强轻量级多模态智能体基座、0.8B 在手机上实现视频理解。从云端到边缘,Qwen3.5 是 2026 年 AI 生态中最值得关注的开源模型家族。
更多文章