MOSS-VL-Realtime 开源:11B 实时视频理解模型,真正开始边看边回答
MOSS-VL-Realtime 技术介绍与快速开始:OpenMOSS 开源 11B 实时视频理解模型,支持 256K 上下文、时间戳帧输入、边看边答、主动沉默和动态修正,适合连续视频流多模态理解。
MOSS-VL-Realtime OpenMOSS 视频理解
15 min read

12 篇文章
了解文本、图像与语音多模态模型,比较输入输出能力和部署条件。
多模态能力需要具体到输入和输出类型:能理解图像不等于能够生成图像。选型时同时检查视频采样、音频延迟、上下文限制和推理框架支持。
MOSS-VL-Realtime 技术介绍与快速开始:OpenMOSS 开源 11B 实时视频理解模型,支持 256K 上下文、时间戳帧输入、边看边答、主动沉默和动态修正,适合连续视频流多模态理解。
Google 发布 Gemma 4 多模态开放模型,密集+MoE 双架构,支持 25.6 万 token 长上下文,原生推理模式,从手机到服务器全场景覆盖。
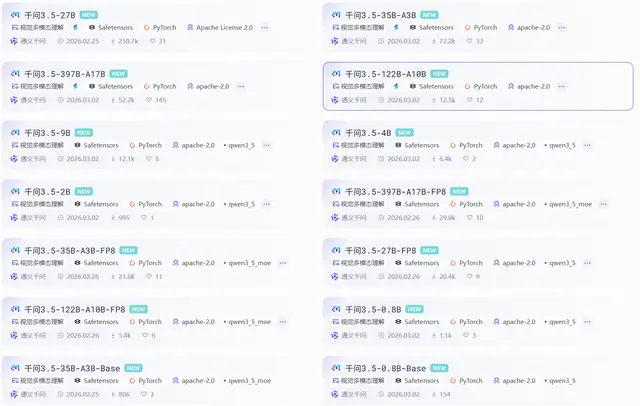
Qwen3.5 MoE系列(0.8B-397B)采用Gated DeltaNet混合注意力。9B超越120B模型,0.8B可在手机处理视频。百万token上下文,原生多模态,支持201种语言。
Open-AutoGLM 是基于 AutoGLM 构建的手机智能助手框架,支持多模态屏幕理解和自动化操作,用自然语言控制手机完成各种任务。
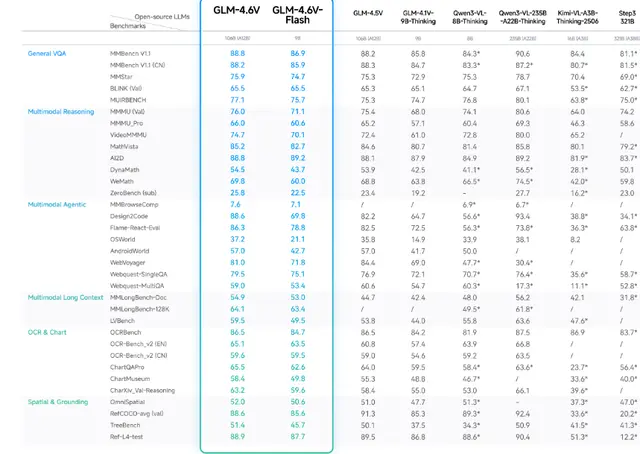
GLM-4.6V 免费开源多模态 AI 大模型完整教程。支持图像识别、OCR文字提取、PDF文档理解、视频分析等功能,128K超长上下文,106B/9B 两个版本可选,支持本地部署和云端调用,包含下载安装、API使用、实战案例等详细说明
Qwen3-Omni 端到端多模态模型,支持文本/图像/音频/视频与实时语音,Thinker–Talker + MoE,多码本降延迟;覆盖 119 种语言,附评测结论、部署建议与 vLLM/Transformers 实操。
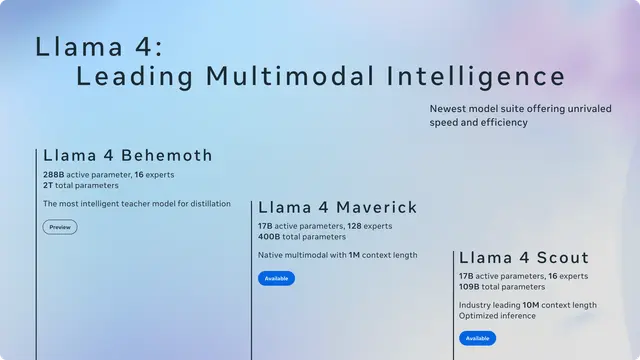
Meta Llama 4涉嫌刷榜争议与高管离职风波交织,AI战略面临考验
7B参数的通义千问Qwen2.5-Omni与2.8B参数的MiniCPM-V参数本地部署全解析:一个需要云端GPU部署实现全模态交互,一个可在手机端运行实现高效视觉理解。本文详细对比两者在参数规模、硬件需求、部署优化和应用场景上的差异,为AI模型选型提供参考。
xAI发布的Grok 3新增图片编辑功能,与谷歌Gemini模型形成直接竞争。Grok 3集成Aurora模型,通过聊天驱动实现图片编辑,在保持人物一致性方面表现出色,而谷歌Gemini同样展示了强大的多模态能力,但尚未完全向公众开放。
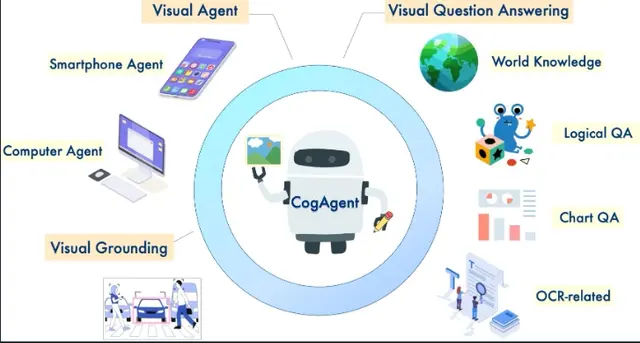
CogAgent-9B: 智谱AI与清华大学联合打造的革命性GUI智能体,以9B参数量实现卓越的界面理解与自动化交互能力,在MM-Vet等多项基准测试中大幅领先现有模型
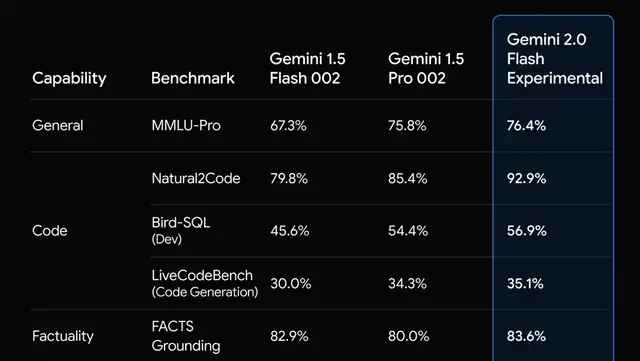
Google 最新发布的 Gemini 2.0 Flash AI模型完整介绍:性能提升2倍、多模态能力、应用场景及未来规划。深入解析其在AI助手、编程开发、数据分析等领域的革新。
Ivy-VL轻量级视觉语言模型重磅发布:3B参数超越7B性能,支持AI眼镜实时部署,OpenCompass榜单4B以下第一,开源免费可商用。AI Safeguard联合CMU斯坦福打造端侧视觉AI新标杆。