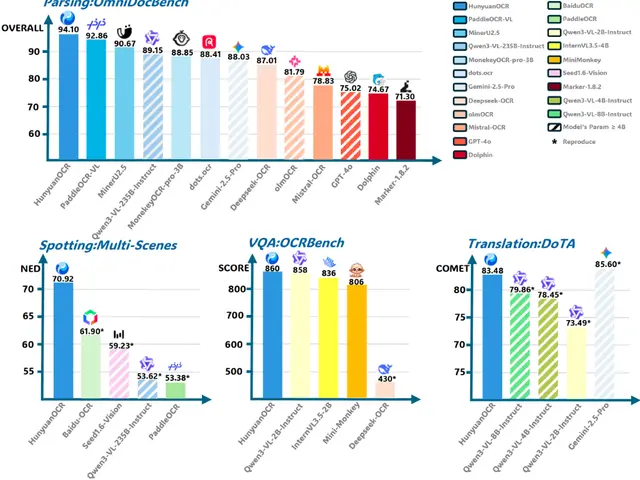
HunyuanOCR 教程:1B 参数超越 DeepSeek/PaddleOCR/Qwen 的腾讯开源 OCR 模型部署指南
HunyuanOCR 开源教程:腾讯混元 1B 参数 OCR 模型,性能全面超越 DeepSeek-OCR、PaddleOCR 和 Qwen3-VL-235B。卡证识别 92% vs DeepSeek 10%,视频字幕提取 92% vs 5%。支持 100+ 语言,提供 vLLM OpenAI API 部署完整代码。
5 篇文章
比较视觉语言模型的图像理解能力,查找文档、界面和视频相关实践。
从实际图片类型与任务开始评估视觉语言模型,例如文档问答、界面定位或场景理解。测试分辨率、细小文字和多图输入,避免只用单张简单图片判断效果。
HunyuanOCR 开源教程:腾讯混元 1B 参数 OCR 模型,性能全面超越 DeepSeek-OCR、PaddleOCR 和 Qwen3-VL-235B。卡证识别 92% vs DeepSeek 10%,视频字幕提取 92% vs 5%。支持 100+ 语言,提供 vLLM OpenAI API 部署完整代码。
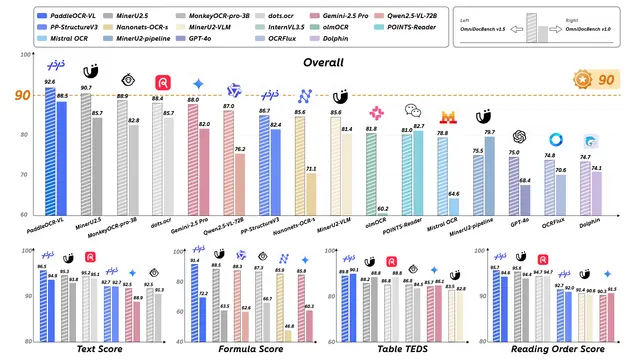
PaddleOCR-VL 完整使用教程:百度最新 0.9B 参数文档解析 AI 模型,支持 109 种语言 OCR 识别,文本表格公式图表一键解析,提供 Docker 部署和 Python API 集成方案,SOTA 性能超越 GPT-4V。
IBM Research发布的轻量级视觉语言模型SmolDocling,仅256M参数,支持全文档OCR和多模态处理,每页处理速度0.35秒,能在消费级显卡上运行,支持文字、公式、代码、图表等多种元素的识别和处理。
详细介绍InternLM-XComposer-2.5-OmniLive(浦语·灵笔2.5)多模态大模型的安装部署、实践教程和性能评测。支持图像、视频、音频等多模态输入,提供完整的中文API使用示例,包含环境配置、模型训练、推理部署等全流程指南。
Ivy-VL轻量级视觉语言模型重磅发布:3B参数超越7B性能,支持AI眼镜实时部署,OpenCompass榜单4B以下第一,开源免费可商用。AI Safeguard联合CMU斯坦福打造端侧视觉AI新标杆。