Qwen3.5-Omni:新一代原生全模态大模型,支持 10 小时音频与 400 万帧视频
Qwen3.5-Omni 是新一代原生全模态大模型,支持文本、图像、音频、视频输入输出。采用 Thinker-Talker 架构和 Hybrid-Attention MoE,支持 256k 上下文、10 小时音频、400 万帧视频处理,在 215 个基准测试中达到 SOTA。
本文发布于 173 天前,内容可能已过时,请注意甄别。
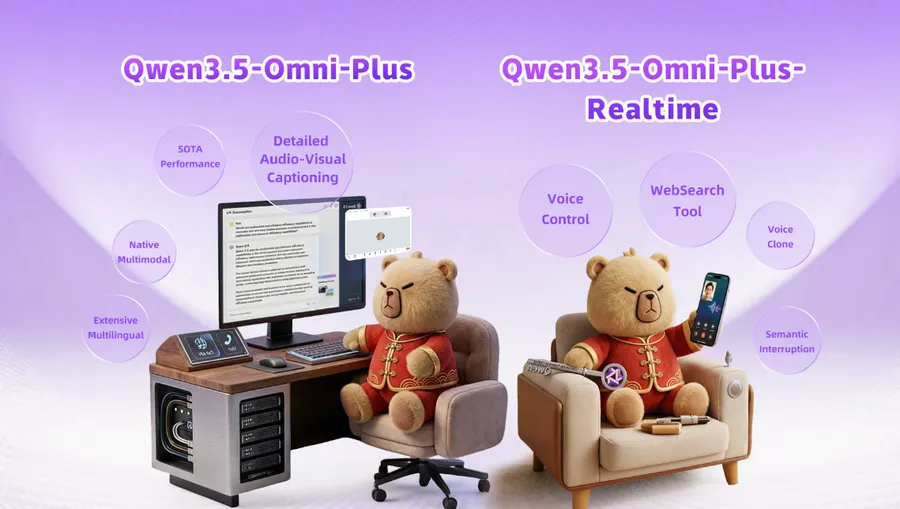
阿里通义千问又放大招了!3 月 30 日,Qwen3.5-Omni 正式发布,这次真的是「全模态」——不仅能看图说话,还能听 10 小时音频、看 400 万帧视频,甚至能听着音乐写代码。更狠的是,在 215 个基准测试中直接拿下 SOTA,把 Gemini-3.1 Pro 按在地上摩擦。
能力炸裂:10 小时音频 + 400 万帧视频,这才叫全模态
说到全模态,很多模型都在吹,但 Qwen3.5-Omni 是真的敢「玩大的」。
核心能力一览
| 能力维度 | 具体指标 | 实际场景 |
|---|---|---|
| 上下文长度 | 256k token | 处理超长文档、完整代码库 |
| 音频处理 | 10 小时连续音频 | 马拉松式会议录音,从头听到尾 |
| 视频理解 | 400 万帧 720P (1 FPS) | 一部两小时电影,一口气看完还能写影评 |
| 语音识别 | 113 种语言和方言 | 从普通话到粤语,从英语到阿拉伯语 |
| 语音生成 | 36 种语言 | 多语言语音输出 |
技术上,阿里这次用了 Thinker-Talker 双架构 + Hybrid-Attention MoE。简单说,就是把「理解」和「表达」分开处理,一个负责看懂听懂,一个负责说话生成,配合混合注意力机制,效率直接拉满。
三大版本对比
| 版本 | 定位 | 适用场景 |
|---|---|---|
| Qwen3.5-Omni-Plus | 旗舰版 | 性能最强,适合复杂任务 |
| Qwen3.5-Omni-Flash | 平衡版 | 性能与速度兼顾 |
| Qwen3.5-Omni-Light | 轻量版 | 快速响应,资源占用少 |
性能炸场:215 个榜单 SOTA,Gemini 被全面超越
数据不会骗人。Qwen3.5-Omni-Plus 这次在 215 个数据集和 Benchmark 上拿下 SOTA。
性能覆盖范围
| 任务类型 | Benchmark 数量 | 说明 |
|---|---|---|
| 视频理解 | 3 个 | 视频内容分析、场景识别 |
| 音频理解 | 5 个 | 音频分类、事件检测 |
| 语音识别 (ASR) | 8 个 | 通用语音转文字 |
| 语音翻译 (S2TT) | 156 个 | 多语言语音到文本翻译 |
| 多语言 ASR | 43 个 | 多语言语音识别 |
与 Gemini-3.1 Pro 对比
| 能力维度 | Qwen3.5-Omni-Plus | Gemini-3.1 Pro |
|---|---|---|
| 音频理解 | ✅ 全面超越 | ❌ 落后 |
| 音频问答 | ✅ 全面超越 | ❌ 落后 |
| 语音识别 | ✅ 全面超越 | ❌ 落后 |
| 语音翻译 | ✅ 全面超越 | ❌ 落后 |
| 语音对话 | ✅ 全面超越 | ❌ 落后 |
| 视频理解 | ✅ 持平 | ✅ 持平 |
| 文本能力 | ✅ Qwen3.5 水准 | - |
| 视觉能力 | ✅ Qwen3.5 水准 | - |
这意味着什么?以前你可能需要三个模型分别处理文本、图像、音频,现在一个 Qwen3.5-Omni 全搞定,而且每项能力都是顶级水平。
黑科技:听着音乐就能写代码?
最让人眼前一亮的是 Audio-Visual Vibe Coding。
简单说,就是你可以用音频指令让 AI 写代码。不是语音转文字再执行,而是模型直接理解音频中的编程意图,然后生成代码。这是全模态模型独有的「涌现能力」,单模态模型根本做不到。
另外,Qwen3.5-Omni-Plus 的音频 caption 生成也很强悍:不仅能生成详细的音频描述,还能自动标注时间戳,精确到每个声音细节。这对视频字幕生成、音频内容分析来说简直是神器。
实时交互:比真人对话还自然
离线能力强是一回事,实时交互才是真正考验功力的地方。Qwen3.5-Omni 的 Realtime 模式直接把体验拉满。
Realtime 模式核心特性
| 特性 | 功能说明 | 实际体验 |
|---|---|---|
| 自动 Turn-taking | 模型自己判断何时说话、何时倾听 | 像真人聊天,该接话时自然接上,不抢话不冷场 |
| 原生 WebSearch | 自主判断是否需要搜索 | 问天气会实时查,问常识直接答 |
| 多轮对话控制 | 控制语速、音量、情绪 | 想要商务风格还是聊天风格,随你调 |
| 角色克隆 | 上传音色样本即可克隆 | 用自己的声音和 AI 对话 |
| ARIA 技术 | 动态调整文本和音频节奏 | 实时性和流畅度兼得,不卡顿不漏字 |
ARIA 技术:解决语音合成的老大难
传统语音合成有个老毛病:要么漏字,要么重复,要么蹦出奇怪的字符,还经常卡顿。
阿里这次搞了个 ARIA(Adaptive Rate Interleave Alignment)技术,动态调整文本和音频元素的节奏。结果就是:实时性和流畅度兼得,说话不卡顿,发音自然流畅,听起来就像真人在说话。
怎么用?两套 API 随便选
| API 类型 | 适用场景 | 典型应用 |
|---|---|---|
| Offline API | 批量处理、深度分析 | 分析一整天的会议录音、给电影生成详细字幕 |
| Realtime API | 实时对话、语音交互 | 智能客服、语音助手、实时翻译 |
而且可以通过 system prompt 自定义模型的说话风格、语速、情绪,想要严肃的商务风格还是轻松的聊天风格,随你调。
技术揭秘:Thinker-Talker + 原生多模态训练
核心架构
| 组件 | 功能 | 作用 |
|---|---|---|
| Thinker | 理解模块 | 负责看懂、听懂输入内容 |
| Talker | 生成模块 | 负责说话、输出响应 |
| Hybrid-Attention MoE | 混合注意力 + 专家混合 | 效率和效果都拉满 |
关键是原生多模态预训练:不是先训练文本模型再加音视频能力,而是从一开始就在文本、图像、长达 1 小时的音视频数据上一起训练。这样才能出现 Audio-Visual Vibe Coding 这种「涌现能力」。
能干啥?场景多到数不过来
| 应用场景 | 核心能力 | 实际价值 |
|---|---|---|
| 智能客服 | 多语言实时语音对话 + 音色克隆 | 24 小时不间断服务,还能用客服的声音 |
| 内容创作 | 自动字幕生成 + 音频描述 | UP 主的福音,省去大量后期时间 |
| 教育培训 | 多模态教学 + 语音交互 | 学生语音提问,AI 语音回答 |
| 开发工具 | Audio-Visual Vibe Coding | 听着音乐写代码(不是开玩笑) |
| 辅助工具 | 音频转录 + 多语言翻译 + 视频分析 | 会议记录、跨语言沟通、视频内容理解 |
写在最后
Qwen3.5-Omni 的发布,标志着全模态大模型进入了新阶段。
不再是「能处理多种模态」就叫全模态,而是要做到:每种模态都是顶级水平,模态之间还能产生化学反应。听音频写代码、看视频生成字幕、实时语音对话不卡顿——这些能力单独拿出来都很强,组合起来就是降维打击。
更重要的是,阿里这次不仅放出了模型,还提供了完整的 API 和 Demo。开发者可以直接上手,不用等。
全模态 AI 的未来,可能比我们想象的来得更快。
更多文章