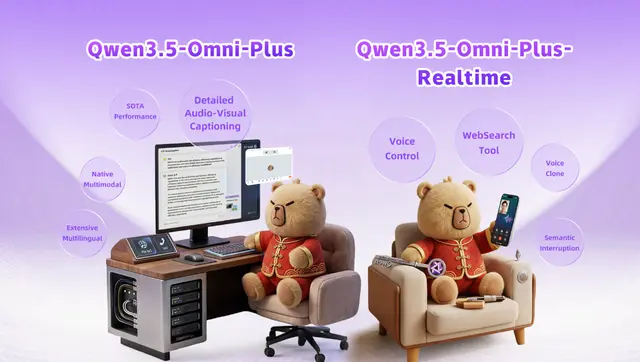
Qwen3.5-Omni:新一代原生全模态大模型,支持 10 小时音频与 400 万帧视频
Qwen3.5-Omni 是新一代原生全模态大模型,支持文本、图像、音频、视频输入输出。采用 Thinker-Talker 架构和 Hybrid-Attention MoE,支持 256k 上下文、10 小时音频、400 万帧视频处理,在 215 个基准测试中达到 SOTA。
Qwen3.5-Omni 全模态模型 AI 模型
9 min read

2 篇文章
浏览关于 实时交互 的 2 篇文章、工具介绍与使用记录,按发布时间查找相关内容。
Qwen3.5-Omni 是新一代原生全模态大模型,支持文本、图像、音频、视频输入输出。采用 Thinker-Talker 架构和 Hybrid-Attention MoE,支持 256k 上下文、10 小时音频、400 万帧视频处理,在 215 个基准测试中达到 SOTA。
Qwen3-Omni 端到端多模态模型,支持文本/图像/音频/视频与实时语音,Thinker–Talker + MoE,多码本降延迟;覆盖 119 种语言,附评测结论、部署建议与 vLLM/Transformers 实操。