开源项目
· 15 min read
MOSS-VL-Realtime 开源:11B 实时视频理解模型,真正开始边看边回答
MOSS-VL-Realtime 技术介绍与快速开始:OpenMOSS 开源 11B 实时视频理解模型,支持 256K 上下文、时间戳帧输入、边看边答、主动沉默和动态修正,适合连续视频流多模态理解。
影响:开源社区 阅读

持续更新 Cv 分类下的精选文章、教程和工具动态。
MOSS-VL-Realtime 技术介绍与快速开始:OpenMOSS 开源 11B 实时视频理解模型,支持 256K 上下文、时间戳帧输入、边看边答、主动沉默和动态修正,适合连续视频流多模态理解。
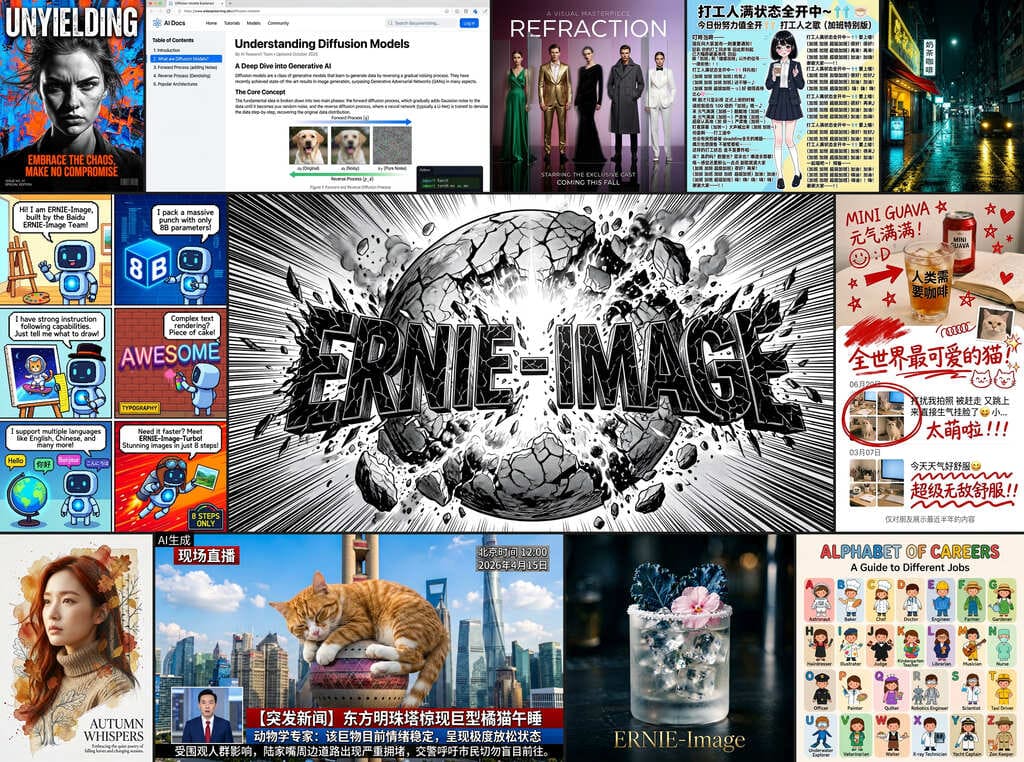
百度开源文生图模型 ERNIE-Image,仅 8B 参数达到开源 SOTA 性能。配备轻量级 Prompt Enhancer,在文本渲染、指令遵循、结构化生成等方面表现优异。GenEval 总分 0.8856,LongTextBench 中英文均超 0.96,24GB 显存即可运行。同步发布 Turbo 版本,8 步推理即可生成高质量图像。
GLM-Image 是首个开源的工业级离散自回归图像生成模型,采用混合架构结合自回归模块与扩散解码器,在文本渲染和知识密集型生成场景中表现出色。本文介绍其技术特点与快速使用方法。
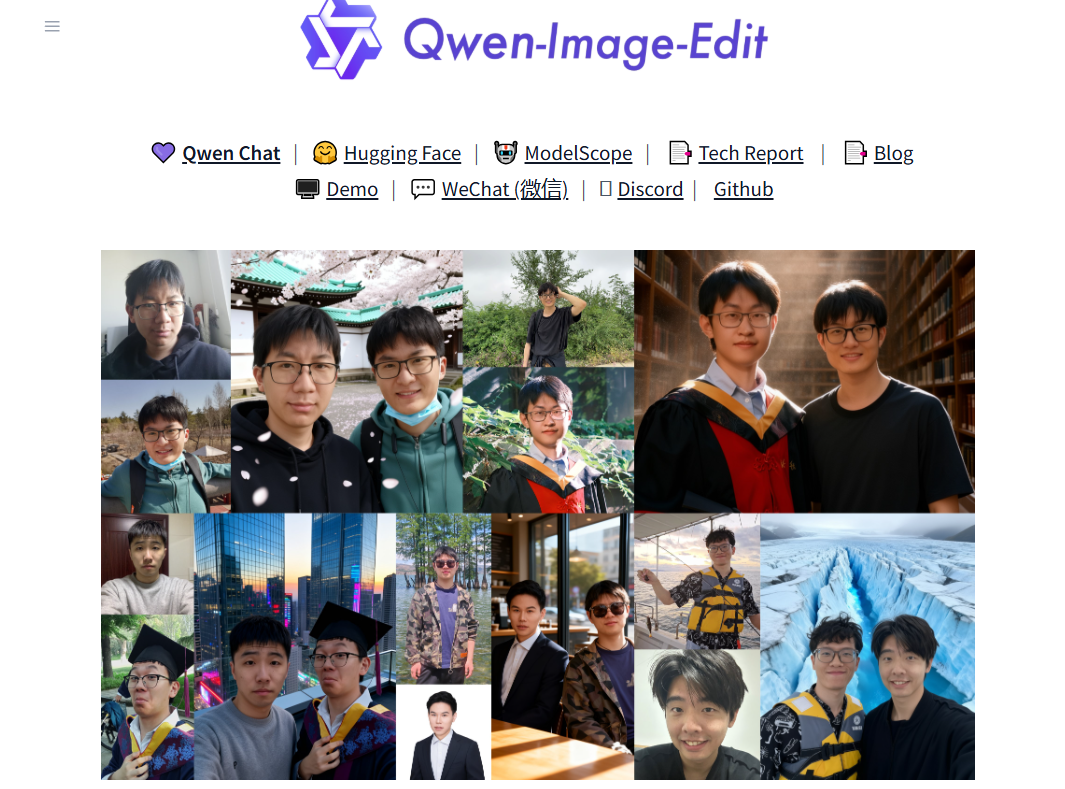
Qwen-Image-Edit-2511 是 Qwen-Image-Edit-2509 的增强版本,主打更稳的角色一致性、更少的图像漂移,并把部分社区 LoRA 能力“内置化”。本文用偏口语但技术向的方式,带你快速了解它能做什么、怎么用 diffusers 跑起来,以及哪些场景最值。
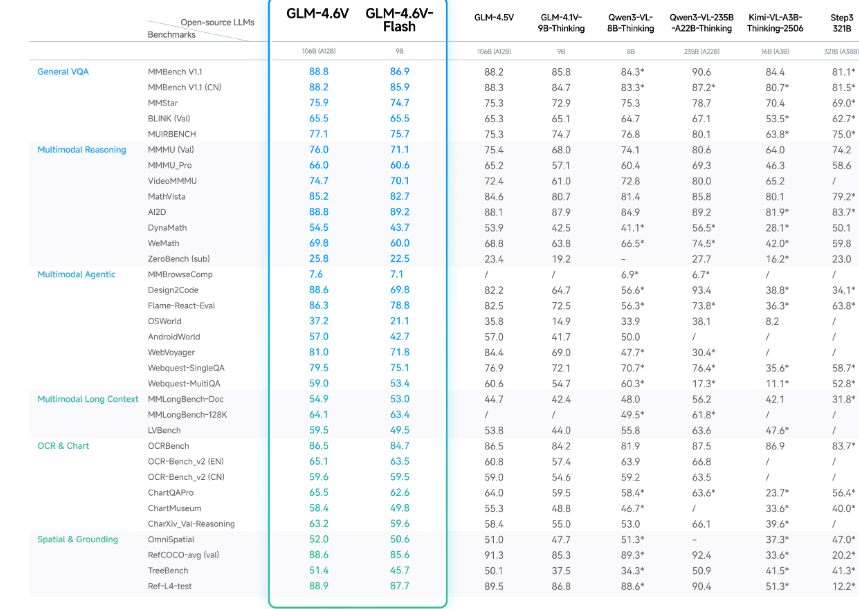
GLM-4.6V 免费开源多模态 AI 大模型完整教程。支持图像识别、OCR文字提取、PDF文档理解、视频分析等功能,128K超长上下文,106B/9B 两个版本可选,支持本地部署和云端调用,包含下载安装、API使用、实战案例等详细说明
Z-Image(造相)是阿里通义发布的60亿参数开源文生图模型,性能媲美甚至超越闭源模型!8步推理亚秒出图,16G显存可跑。支持中英文文字渲染,AI Arena人类偏好评测领先。本文包含安装部署与代码示例。
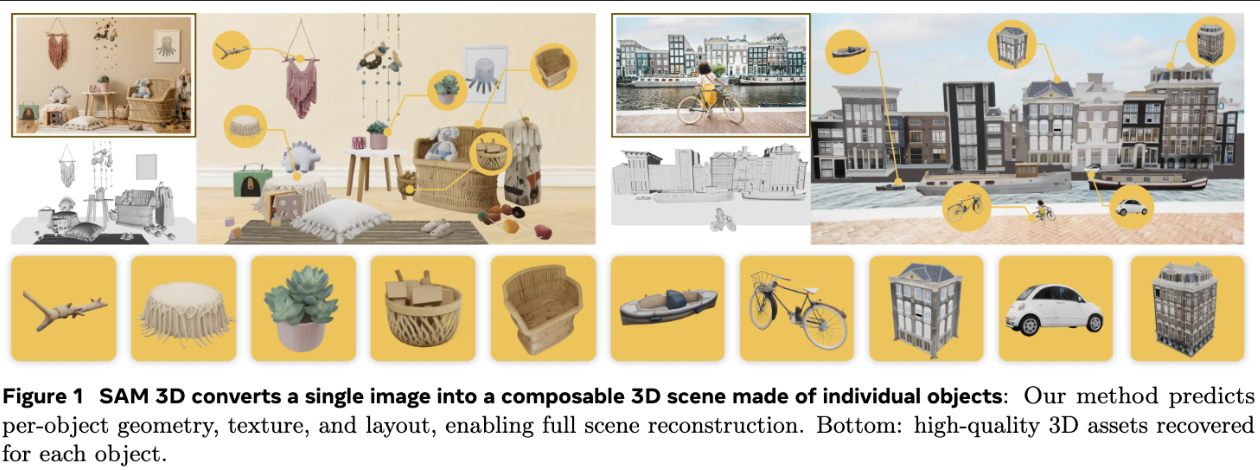
SAM 3D Objects教程:Meta最新单图3D重建模型完全指南。一张图片秒变3D模型,支持复杂场景和遮挡处理。包含详细安装步骤、Python代码示例、实战案例。零基础快速上手SAM 3D,让你的图片立体起来!
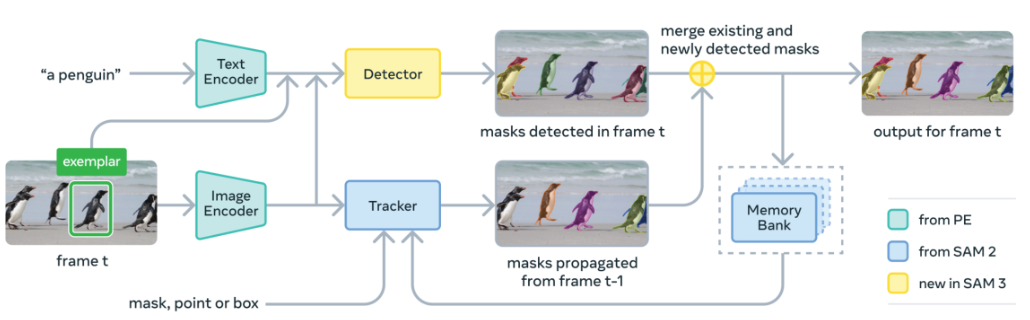
SAM3教程:Meta最新AI图像分割模型完全指南。支持400万+概念的开放词汇分割,文本提示即可精准分割图像视频。包含详细安装步骤、Python代码示例、性能优化技巧。零基础快速上手SAM3模型,提升计算机视觉项目效率。
详细介绍微软开源的TRELLIS大规模3D生成模型,包含本地部署教程、使用方法、最佳实践、性能优化建议,以及如何利用TRELLIS实现高质量的图生3D和文生3D内容生成,支持多种3D表示格式和标准导出

探索STAR(Spatial-Temporal Augmentation with Text-to-Video Models)如何利用文本到视频扩散模型提升真实世界视频的超分辨率效果。通过创新的时空质量增强框架、T2V模型集成、时间一致性保持等技术,有效解决了传统方法的局限。本文详细介绍STAR的技术原理、核心组件及实践指南,帮助读者掌握这一突破性的视频增强技术。
